KV Cache 与数值精度
面试题 同一模型采用不同权重精度或 KV Cache 精度时,KV Cache 的显存占用、容量、性能和精度有什么区别?
控制精度的三个参数
讨论“不同精度”时,需要先区分精度作用在哪类数据上。vLLM 使用下面三个参数分别配置模型的基础浮点精度、权重量化方法和 KV Cache 精度。它们控制的对象不同,对 KV Cache 的影响也不同。
未显式设置
--quantization 时,vLLM 会读取 checkpoint 中的 quantization_config。--quantization awq 通常用于加载已经完成 AWQ 量化的 checkpoint,不会在服务启动时执行需要校准数据的 AWQ 量化。
以 --quantization awq --dtype float16 为例:
- 量化层权重:AWQ W4A16 通常以 Linear 层为量化目标,将其权重保存为 INT4,并按组保存 scale;非对称量化还会保存 zero point。在常见 Llama 类模型中,这些层包括 Attention 的
q_proj、k_proj、v_proj、o_proj和 MLP 的gate_proj、up_proj、down_proj。
量化 scale 和 zero point 是什么?
量化 scale 和 zero point 是什么?
INT4 只能保存 例如:通常是一组权重共享一套 scale 和 zero point,例如每 128 个权重为一组,而不是为每个权重分别保存。对称量化一般不需要单独保存 zero point。
0~15 这样的离散整数。scale 表示相邻两个量化值之间的步长,zero point 表示浮点数 0 对应哪个 INT4 数值。量化 kernel 使用下面的公式近似还原浮点权重:- 激活:W4A16 中的 A16 表示激活使用 16 位浮点格式。在这个示例中,
--dtype float16使 Linear 层的输入和输出激活使用 FP16。量化 kernel 在矩阵乘法过程中读取 INT4 权重和 scale,不会把整份权重长期展开成 FP16 保存在显存中。 - 未量化权重:未被 AWQ 选中或通过
ignore排除的权重仍使用基础浮点 dtype。在本例中,--dtype float16将这些权重设置为 FP16。
KV Cache 显存计算
对于结构统一且 Batch 内序列长度相同的 Decoder-only MHA 或 GQA 模型,KV Cache 主体显存可以用下面的公式估算:
可以使用 Modular LLM Inference Handbook 的 KV Cache 计算说明对照标准公式,也可以通过 KVCache.AI Calculator选择具体模型、序列数量和 KV 精度进行估算。
KV Cache 压缩与物理块回收
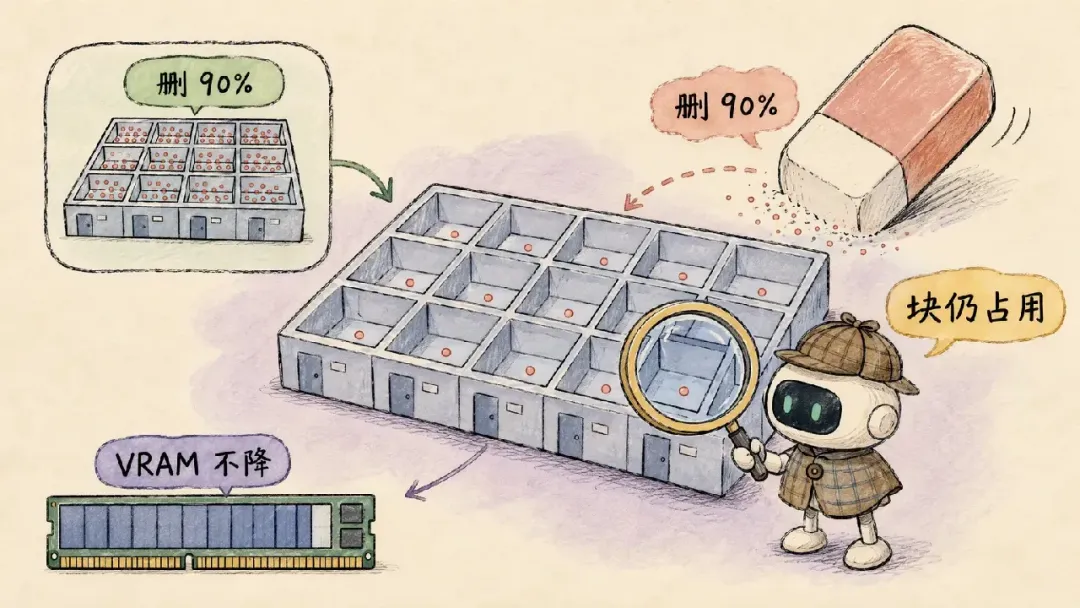
面试题 你正在 vLLM 上部署一个推理模型,但它在长序列生成过程中总是耗尽 GPU 显存。于是你加入 KV Cache 压缩,淘汰了 90% 的缓存 token。压缩后 VRAM 使用量几乎没有下降,模型仍然会因显存不足而停止。为什么?
逻辑删除与物理释放
问题不在模型,而在 KV Cache 的内存管理粒度。 vLLM 这类推理系统采用源自 PagedAttention 的分页式 KV Cache 管理,将显存划分成固定大小的物理块。块大小可以配置,常见配置是每块容纳 16 个 token。压缩算法按 token 选择保留项,显存分配器却按物理块回收空间:只有一个物理块中的所有位置都为空,这个块才能被释放。 假设 16,000 个 token 分布在约 1,000 个物理块中。压缩算法删除其中 14,400 个,只留下 1,600 个重要 token:- 如果幸存 token 被紧凑地排列,只需要约
1,600 ÷ 16 = 100个块,其余约 900 个块可以释放。 - 如果幸存 token 分散在原来的 1,000 个块中,并且几乎每个块都至少保留一个 token,那么这 1,000 个块仍然处于占用状态,分配器几乎无法回收显存。
KV Cache 压缩
许多 KV Cache 淘汰方法通过观察 Attention Score 判断应该保留哪些 token,代表方法包括:- H2O:在每个 Decode Step 为缓存 token 累积历史 Attention Score,同时保留最近 token 和累计得分较高的 Heavy Hitter。缓存达到固定预算后,持续淘汰累计得分较低的 token。
- Scissorhands:基于“重要性具有持续性”的假设,认为过去显著影响输出的 Pivotal Token 以后仍更可能重要。它根据历史 Attention 信号提高这些 token 的保留概率,将 KV Cache 维持在固定预算内。
- TOVA:缓存达到容量上限后,在每个 Decode Step 淘汰当前 Attention Score 最低的 token。它不预留固定的最近窗口,也不固定偏向序列开头的 token。
- SnapKV:在 Prefill 结束时,使用提示末尾的 Observation Window 评估历史 token,并为每个 Attention Head 选择成簇的重要 KV 位置。该方法只执行一次评分,避免在整个 Decode 阶段持续累积 Attention Score。
- PyramidKV:利用 Attention 信息在模型层间逐步汇聚的现象,为较低 Layer 分配更多 KV Cache,为较高 Layer 分配更少缓存。它将统一预算改为按 Layer 变化的金字塔式预算。
- Ada-KV:针对不同 Attention Head 的模式差异,自适应地分配 Head-wise KV Cache 预算。它可以与已有的 Attention Score 淘汰方法组合,减少统一预算造成的保留误差。
- R-KV:面向长链路推理,在 Decode 阶段结合最近观察 token 的 Attention 权重与 Key 向量的余弦相似度。它联合衡量 token 的重要性和语义冗余,优先保留重要且不重复的推理上下文。
生产部署中的两个基础设施问题
- Attention Score 不可用:FlashAttention 等高性能 Attention Kernel 通过 SRAM 分块完成 Attention 计算,不会在 HBM 中生成完整的
N × NAttention Score Matrix。依赖完整历史分数的方法因此无法直接取得评分信号;例如,H2O 的参考实现会退回 Eager Attention 并显式生成完整矩阵,同时失去 FlashAttention 的性能收益。 - 淘汰 token 无法释放物理块:Paged KV Cache 只有在整个物理块为空时才能归还显存,反复执行 token 级淘汰会让幸存 token 分散在不同块中。R-KV 报告的 90% 显存节省基于预分配的连续 Tensor,而不是 vLLM 的分页式内存管理;Quest 则保留完整 KV Cache,只选择每次 Query 需要读取的物理页,因此显存占用仍会随上下文增长。
TriAttention 的两项方案
TriAttention 针对这两个问题分别提出 Pre-RoPE Geometry 和 Forward-Packing Compaction:- Pre-RoPE Geometry:不读取运行时 Attention Score,而是利用应用 RoPE 前 Q/K 向量的稳定几何结构估计 token 重要性。评分过程不依赖 FlashAttention 未写入显存的完整分数矩阵。
- Forward-Packing Compaction:执行 token 级淘汰后,周期性搬移幸存 token 并填补块内空洞。TriAttention 大约每生成 128 个 token 执行一次紧凑化,按原有逻辑顺序将幸存 token 向前排列,使末尾形成完整空块并归还给分配器。