本章概要
分离式推理让多个 Worker 分工完成一次请求。Worker 指执行推理计算的服务实例,下面用 P、D 分别表示 Prefill 和 Decode 实例。拆分后需要解决的核心问题是:计算结果传给谁、存在哪里、何时可以使用和释放。- PD 分离:在 Prefill 与 Decode 之间交接 KV Cache。
- 多模态 EPD 分离:增加编码阶段,将图像编码得到的 embedding(特征向量)传给语言模型。
- Attention–FFN 分离(AFD):把一层中的 Attention 和 FFN 分开执行,反复传递两部分计算所需的中间激活。
PD 分离回顾
Prefill 与 Decode 的阶段特征、基本部署方式见 06 - PD 分离。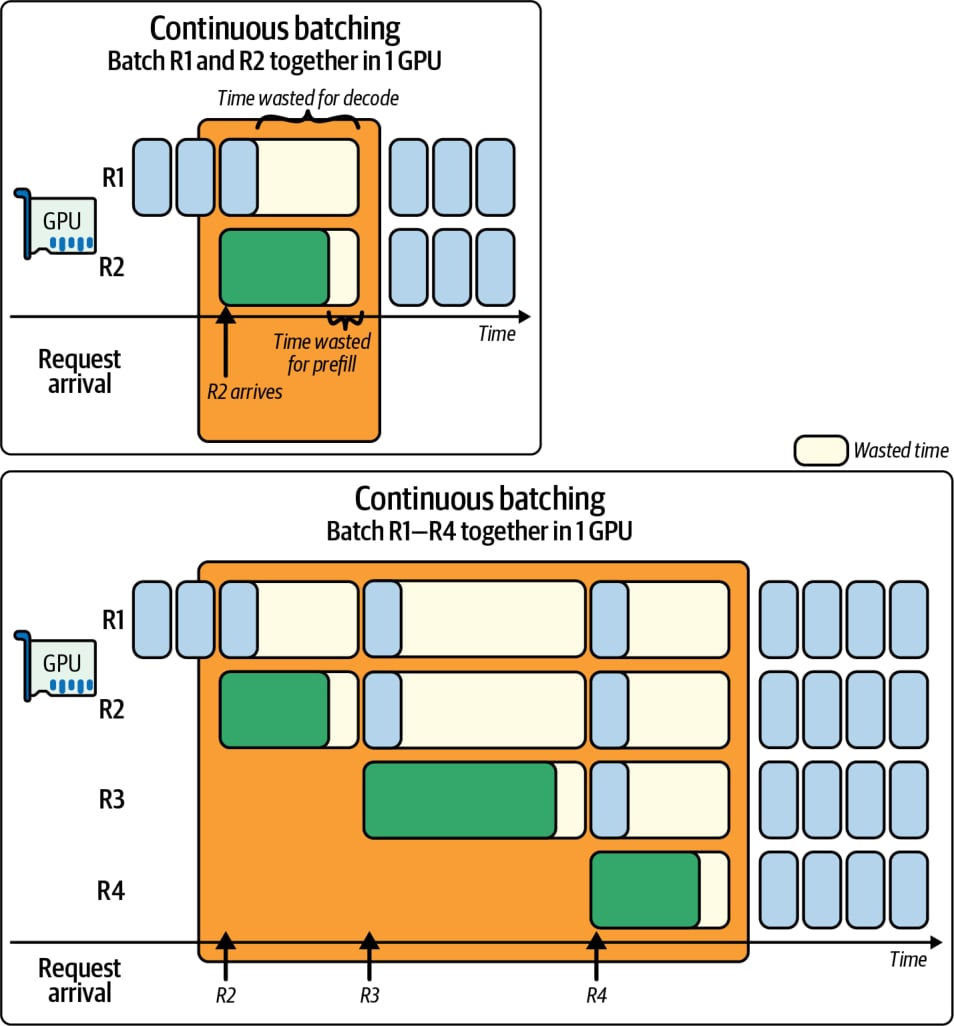
原书图 17-1,图片获取自中英对照 Markdown 仓库。
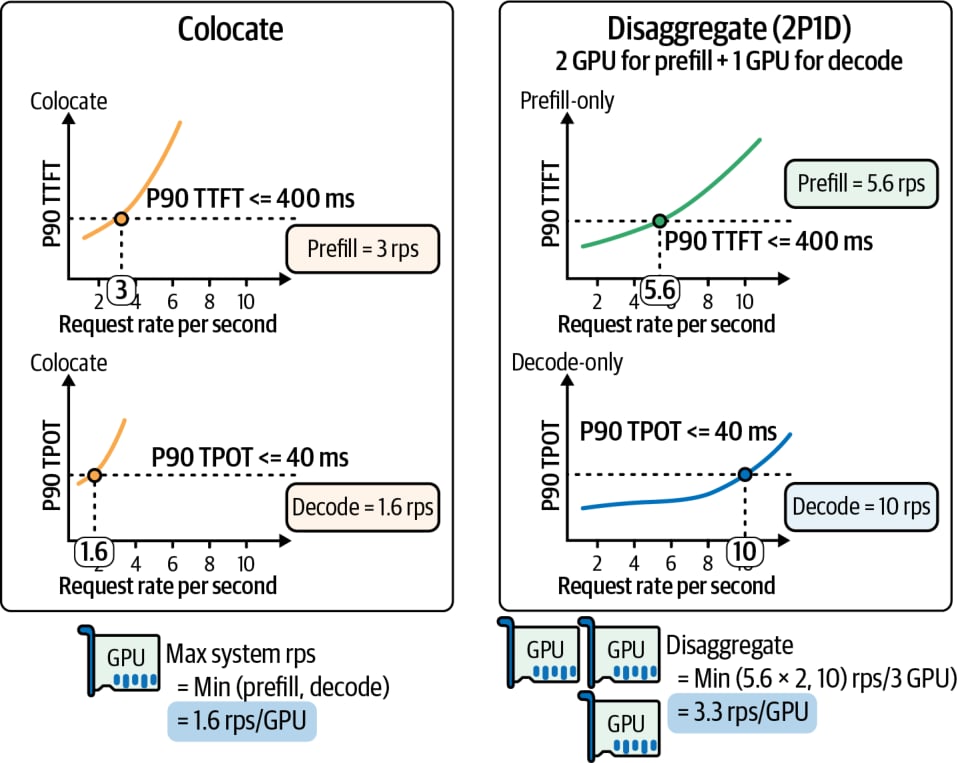
原书图 17-2,实验背景见 DistServe。图中的配置和数值对应特定模型、硬件与 SLO。
分离式推理的组件分工
一个项目可以覆盖多个层次,同一层也可以组合不同项目的组件。 Dynamo 通过接入 vLLM、SGLang、TensorRT-LLM 等引擎执行模型,自身提供 Frontend、Router、Planner 和 KVBM 等组件,分别承担请求协调、容量调整和缓存管理。
根据 [vLLM Connector 接口](https://github.com/vllm-project/vllm/blob/7a64fb8fc9239cb65e0df9313fa759594dfb206a/vllm/distributed/kv_transfer/kv_connector/v1/base.py)、[Dynamo KVBM](https://github.com/ai-dynamo/dynamo/blob/3032e8a703e5680d7481b9e499a6f979ed37bba1/lib/bindings/kvbm/README.md)及下表资料整理。横向色带表示职责分类,Dynamo 纵框内的组件也归入对应行;推理引擎为共用区域,具体组合受版本和引擎支持情况约束。
KVConnectorBase_V1,分别在 Scheduler 和 Worker 中运行,将 vLLM 接入 KVBM。图中将该插件列入 Dynamo 纵框,表示实现来源;它的运行位置仍在引擎内。
Dynamo v1.6.0 的基础 PD 示例 使用 vLLM 的 NixlConnector 交接 KV;接入 KVBM 的示例 则在 P 侧通过 PdConnector 组合 NixlConnector 与 DynamoConnector,分别处理 P→D 传输和分层缓存。
缓存管理决定 KV 存在哪里、保留多久以及能否复用;传输库执行具体的内存读写。Dynamo、Mooncake 和 LMCache 都涉及这两类工作:
vLLM → LMCacheMPConnector → LMCache → Mooncake Store → Mooncake Transfer Engine 是可配置的组合;若只需要 P、D 直接交接 KV,也可以通过引擎 Connector 调用传输库,省去共享缓存池。
Connector 连接引擎与 KV 传输
KV Connector(连接器)让推理引擎能够使用其他实例或外部缓存中的 KV。 它向调度器报告可复用的 KV,将请求对应到具体的缓存块,调用传输库或缓存服务完成加载、保存,并报告完成或失败。调度器据此决定请求何时继续计算、哪些块可以释放。 例如,P 算完一个请求后,D 需要知道 KV 存在 P 的哪些块中、应放入自己的哪些块,以及数据何时可用。Connector 将这些信息与引擎的调度、内存管理衔接起来,底层的 NIXL 或 Mooncake Transfer Engine 则执行具体的数据搬运。vLLM 的 Connector 架构与执行流程
vLLM 的 Connector 分别运行在 Scheduler 进程和各个 GPU Worker 进程中:调度侧衔接 KV 查询、块分配和请求状态,Worker 侧执行加载和保存。 这里的 Scheduler 属于一个 vLLM 引擎;P、D 各有自己的 Scheduler。Dynamo Router 选择服务实例,实例内的 Scheduler 再决定哪些请求进入本轮计算、使用哪些 KV 块。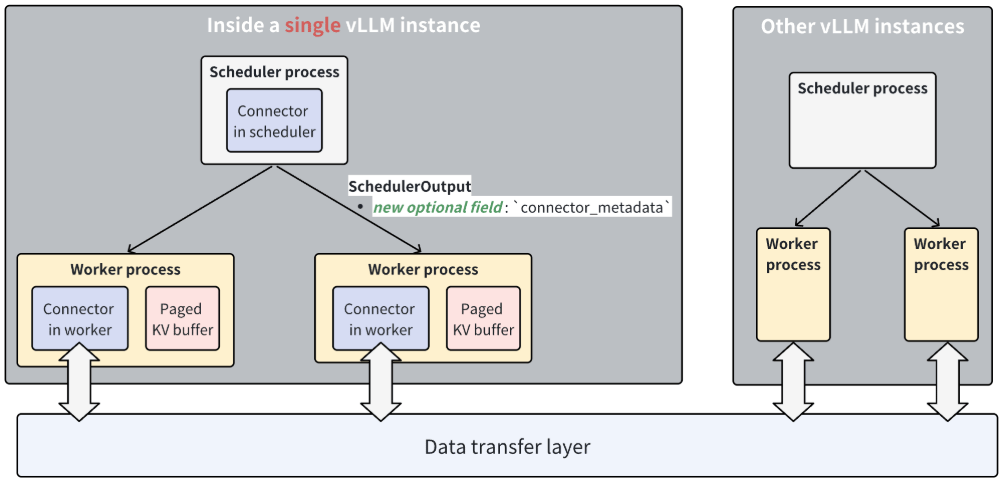
来源:[vLLM — Disaggregated Prefilling](https://github.com/vllm-project/vllm/blob/7a64fb8fc9239cb65e0df9313fa759594dfb206a/docs/features/disagg_prefill.md#development)。图中的 `connector_metadata` 在本文采用的源码版本中对应 `kv_connector_metadata`。
SchedulerOutput 下发请求、块位置等传输信息;底部的双向粗箭头表示实际 KV 数据的传输。Paged KV buffer 是 Worker 持有的分页 KV 缓存,Worker 侧 Connector 将这些缓存块与底层传输库对接。
调度侧 Connector 通过 KVConnectorBase_V1 向调度器报告外部有哪些 KV 可以复用。调度器分配本地 GPU 块后,Connector 再把块的位置和传输任务交给 Worker 执行。这里需要区分:外部找到了 KV,不等于 KV 已经加载到本地、可以用于计算。
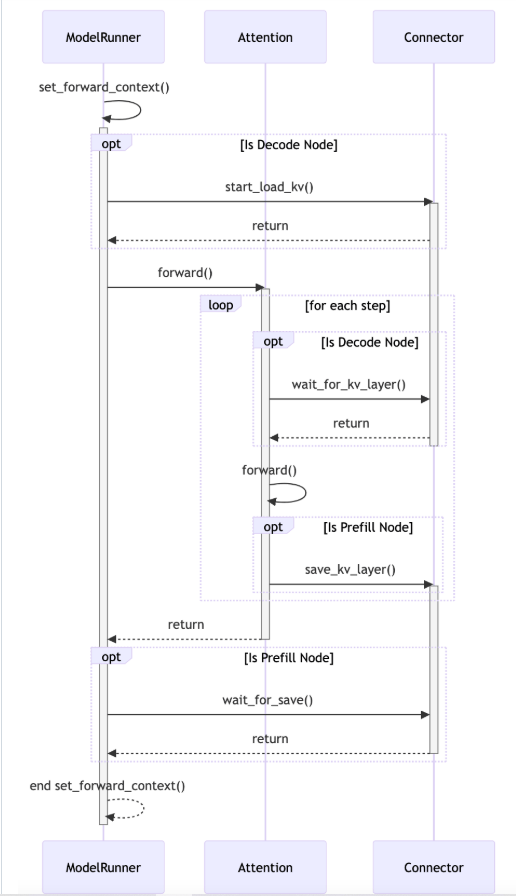
来源:[vLLM — Disaggregated Prefilling 的 Worker 时序图](https://github.com/vllm-project/vllm/blob/7a64fb8fc9239cb65e0df9313fa759594dfb206a/docs/features/disagg_prefill.md#development)。图中的 `wait_for_kv_layer` 对应本文源码版本的 `wait_for_layer_load`;图展示接口调用位置,具体 Connector 决定按层传输还是按请求传输。
start_load_kv 启动加载。对于按层加载的实现,Attention 在使用该层 KV 前调用 wait_for_layer_load 等待就绪;计算出 KV 后,可以通过 save_kv_layer 提交保存。wait_for_save 负责提交保存任务并执行必要的同步,异步传输的最终完成结果再交回调度器。
调度器与 Worker 通过以下接口衔接一次传输:
request_finished 可以要求延迟释放,直到完成通知到达。若在计算结束时立即把这些块分配给新请求,远端读取就可能遇到被覆盖的数据。
同样,Decode 分配接收块只代表已经留出了空间。KV 尚未传完时,Attention 还不能使用这些块;加载失败也需要通知调度器,避免使用不完整的数据。
不同 Connector 的 KV 路径
直接传输的 Connector 负责把当前请求从 P 交给 D;接入缓存服务的 Connector 还可以保存 KV,供后续请求复用。下表按本文采用的源码版本比较这些实现。NIXL Pull 与 Push
NIXL 负责注册可用于传输的内存,并在这些内存区域之间异步搬运数据。vLLM Connector 则找出请求所需 KV 对应的实际内存块,决定何时传输、何时通知调度器。即使底层使用 RDMA,Connector 仍需匹配两侧请求,并决定 KV 块何时可以释放。 NIXL Pull 路径 由 Decode 根据 Prefill 提供的 KV 位置等信息发起READ;Push 路径 由 Prefill 向 Decode 已注册的目标位置发起 WRITE。
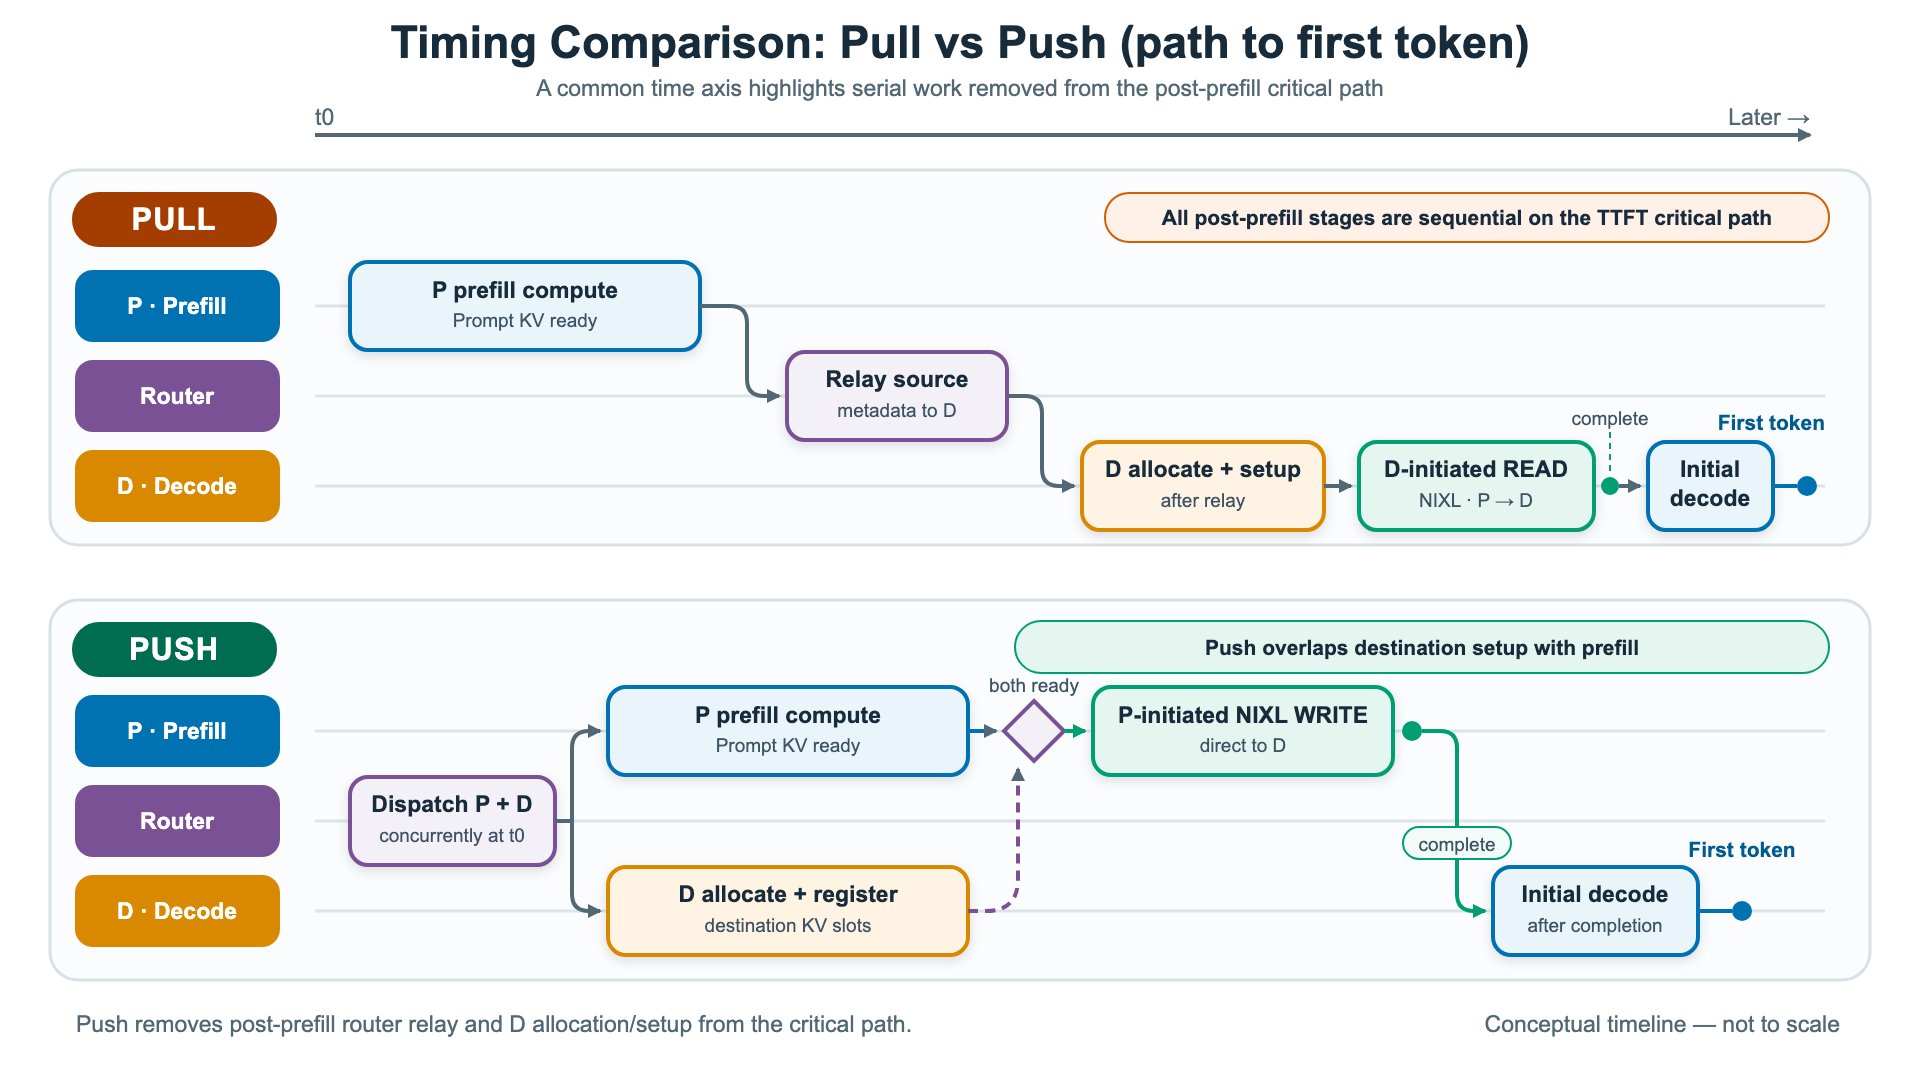
- 早选 D:目标分配和注册可以与 P 的工作重叠,D 的 KV 容量也会在真正开始生成之前就被占用。
- 晚选 D:可以利用更新的负载信息,但接收端准备工作可能落在 Prefill 之后。
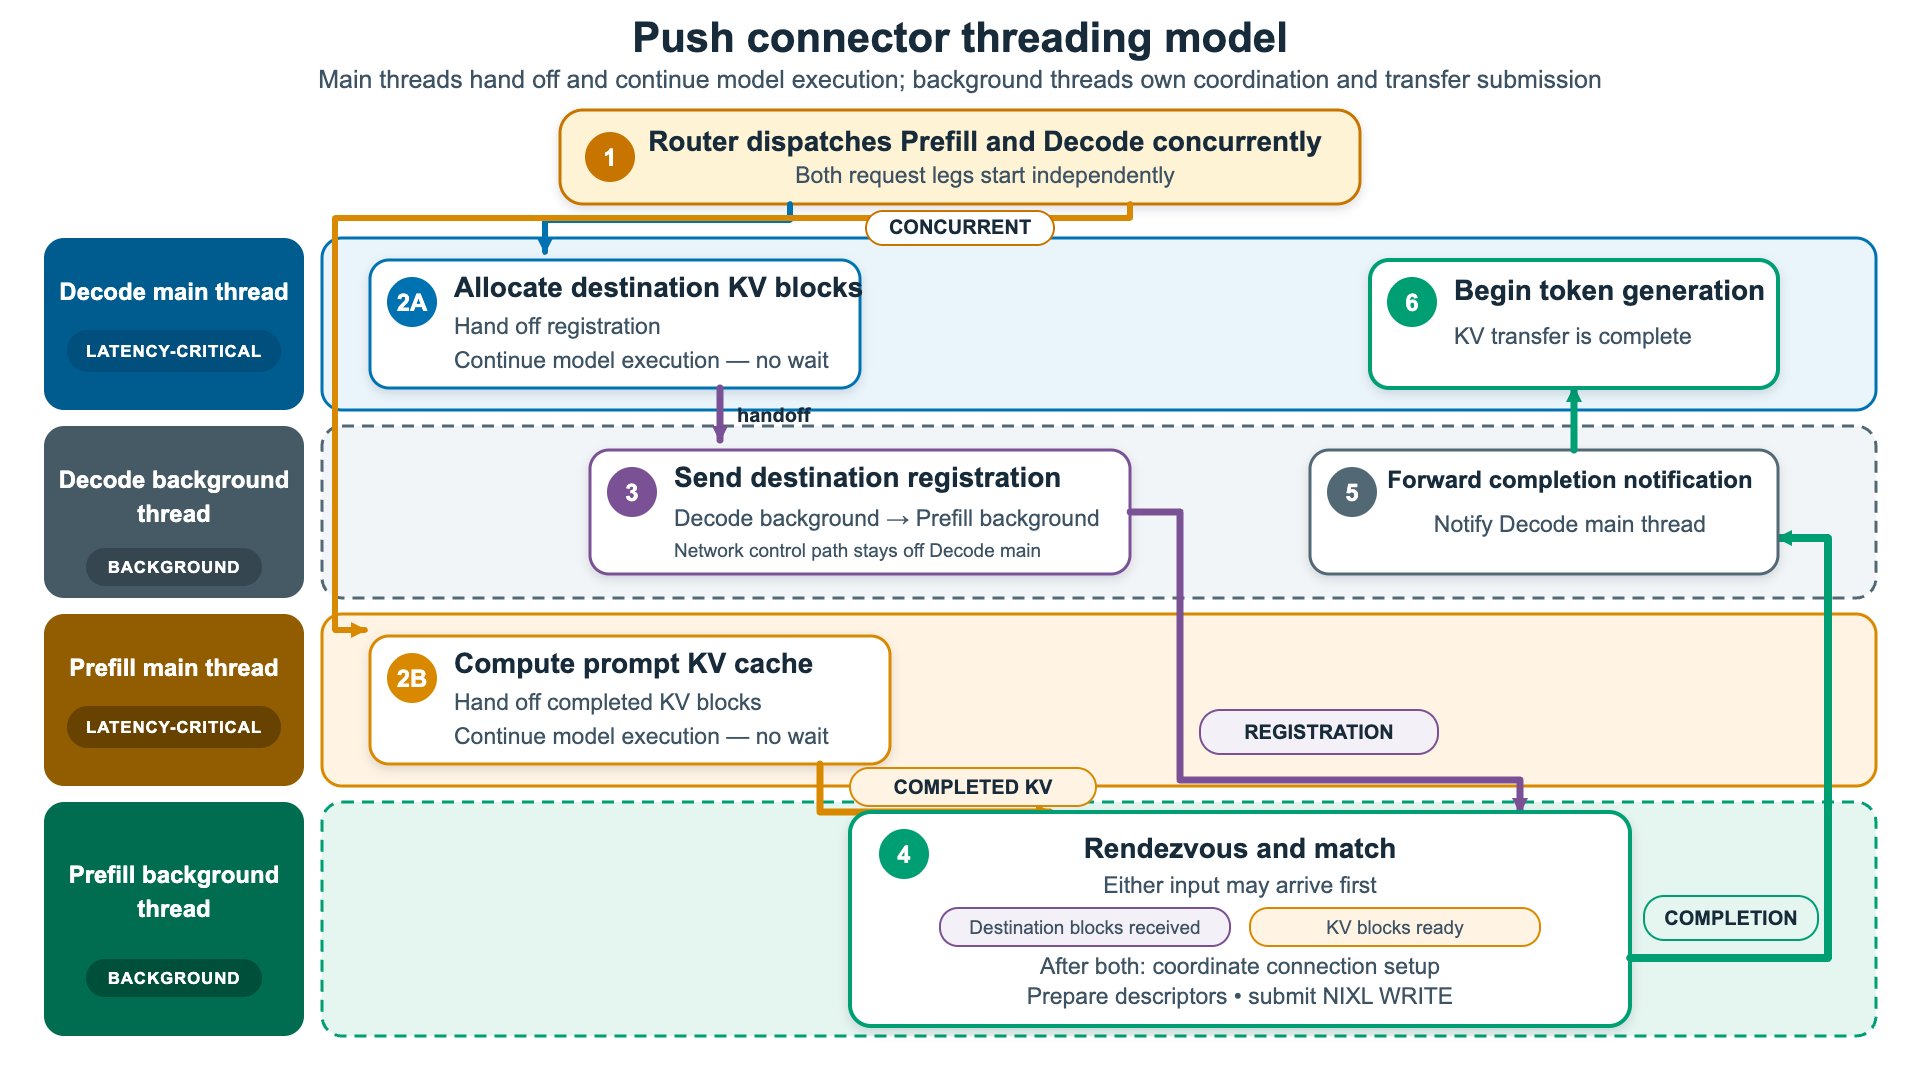
来源同上;实现细节见 NIXL Push Connector 设计。
Mooncake 的直接传输与共享存储
Mooncake Transfer Engine 用 Segment 描述远端可访问的内存或存储区域,用 BatchTransfer 提交一组异步读写。两端先通过元数据服务或直接握手取得地址和连接信息,再直接传输数据;大块数据不经过元数据服务。 vLLM 中的 MooncakeConnector 使用 Transfer Engine 在两个引擎之间传输 KV。它先注册 KV 内存,再交换地址和排列方式,确定每个块需要从哪里读、写到哪里。两端还需核对层、KV 分组、块大小和偏移,因为相同 token 数对应的 KV,在两个实例中的内存排列可能不同。 Mooncake Store Connector 则把 KV 接入共享存储。Store Master 记录 KV 对象存在哪里,管理空间分配、副本和租约;Client 通过 Transfer Engine 传输实际数据。直接传输用于两个引擎交接当前请求的 KV,共享存储则可以在请求结束后继续保存 KV,供后续请求复用。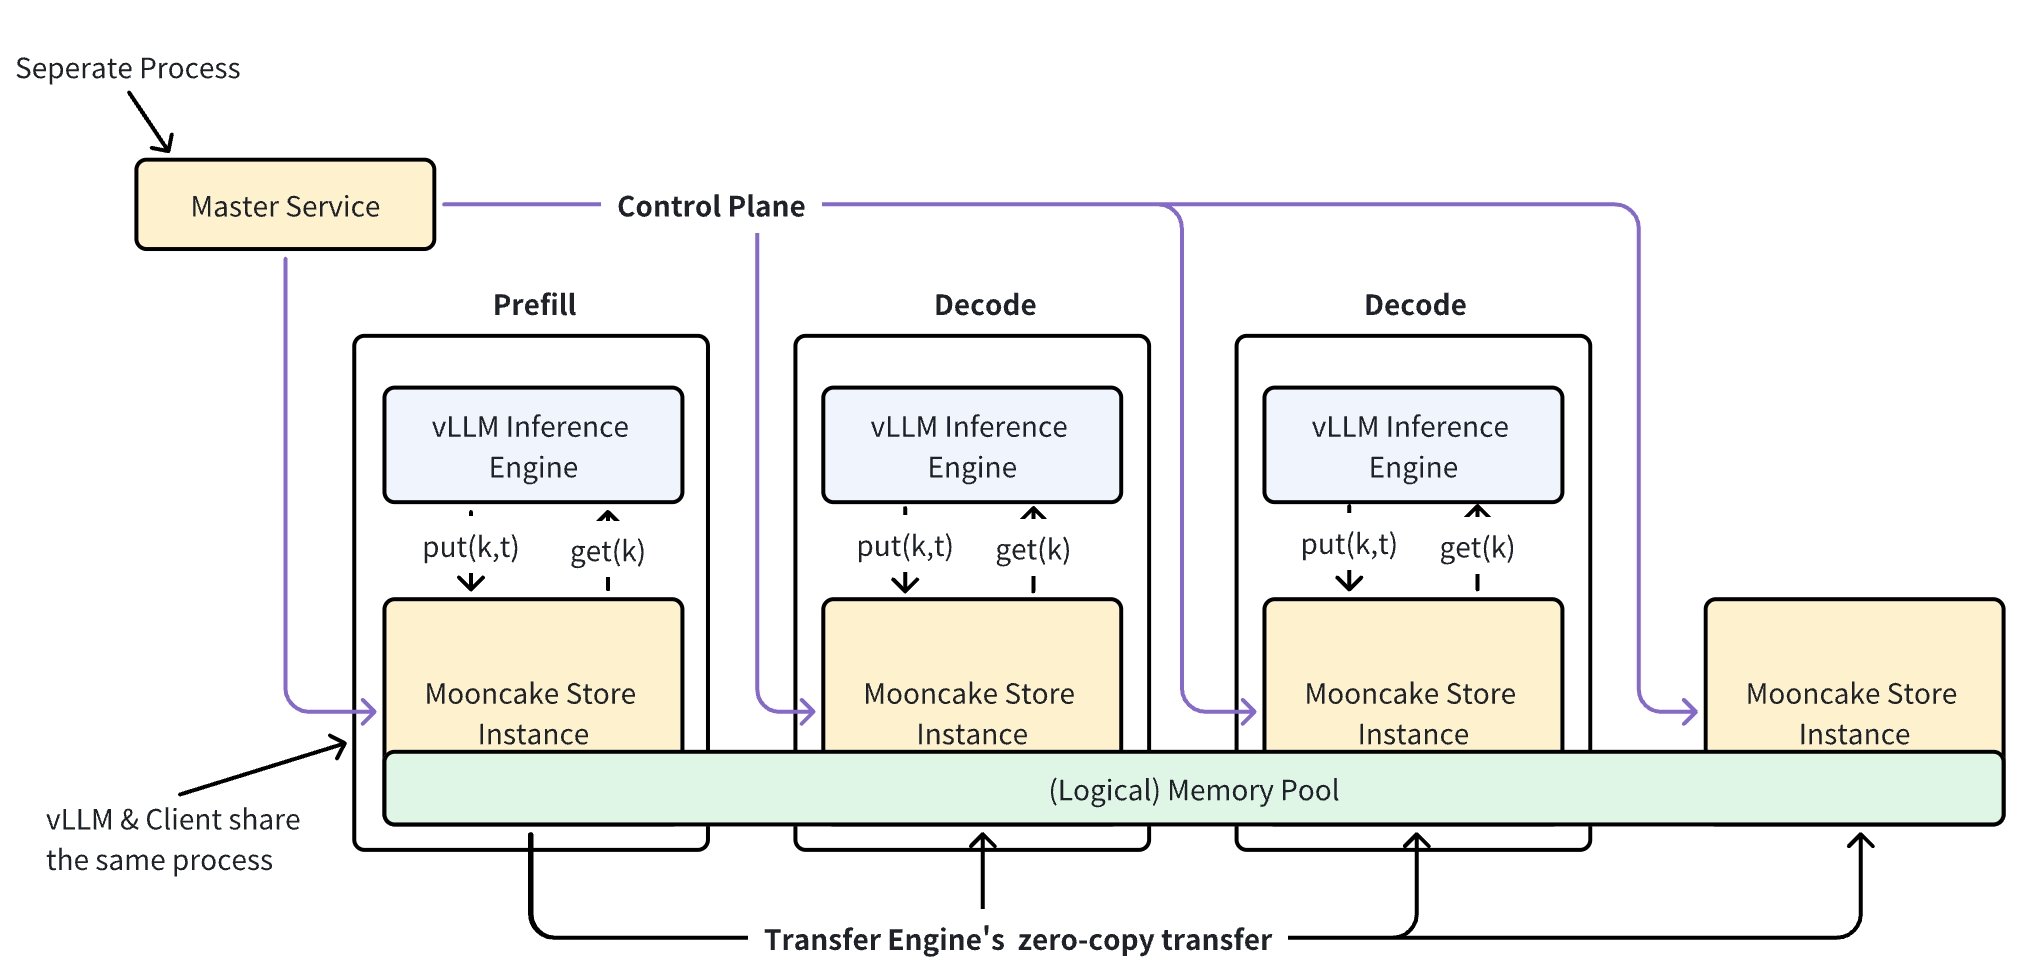
来源:Mooncake Store 架构。图中展示 Client 嵌入 vLLM 进程、也可独立提供存储的部署方式。
MultiConnector 可以组合 PD Connector 与 Store Connector,同时支持当前请求的 P→D 交接和后续请求的 KV 复用。
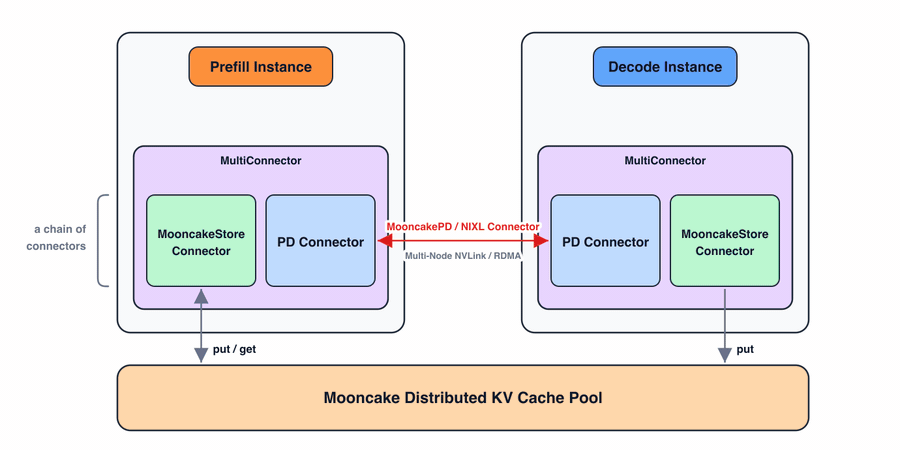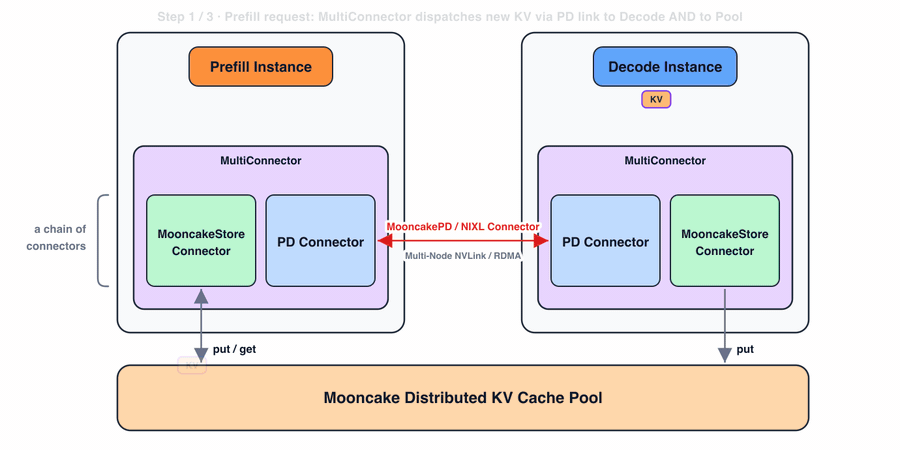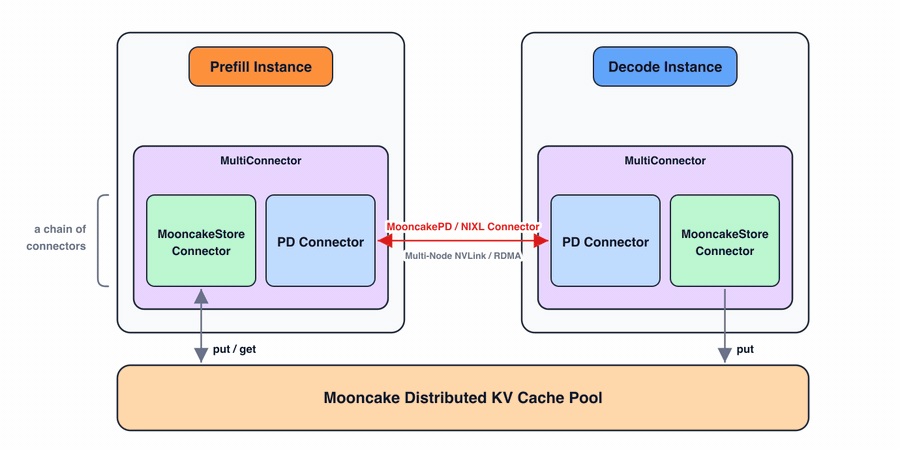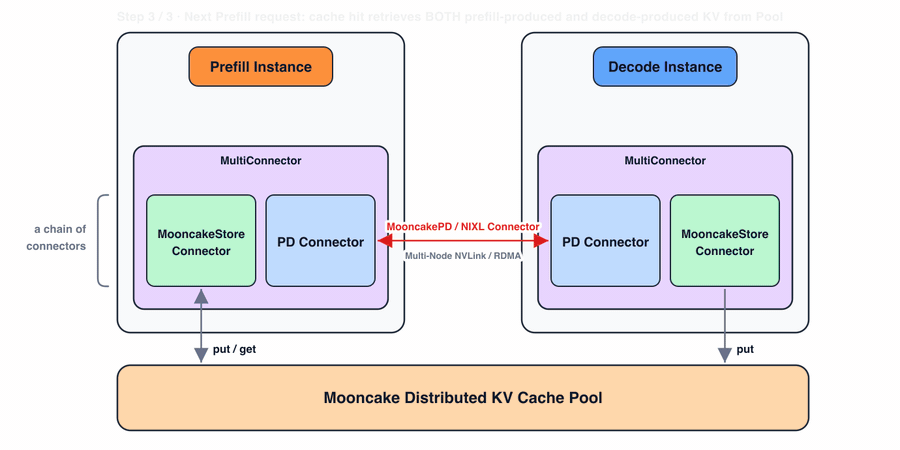
来源:Serving Agentic Workloads at Scale with vLLM x Mooncake,图 3(2026-05-06)。动画展示 MultiConnector 将 PD 分离与分布式 KV 缓存池结合。
LMCache 的独立缓存服务
LMCache 的 MP(多进程)模式将缓存服务放在独立进程中。vLLM 通过LMCacheMPConnector 接入服务,使用 ZMQ RPC 提交保存、查询和加载请求;同机的多个 vLLM 实例可以共享这个服务及其 CPU 内存池。
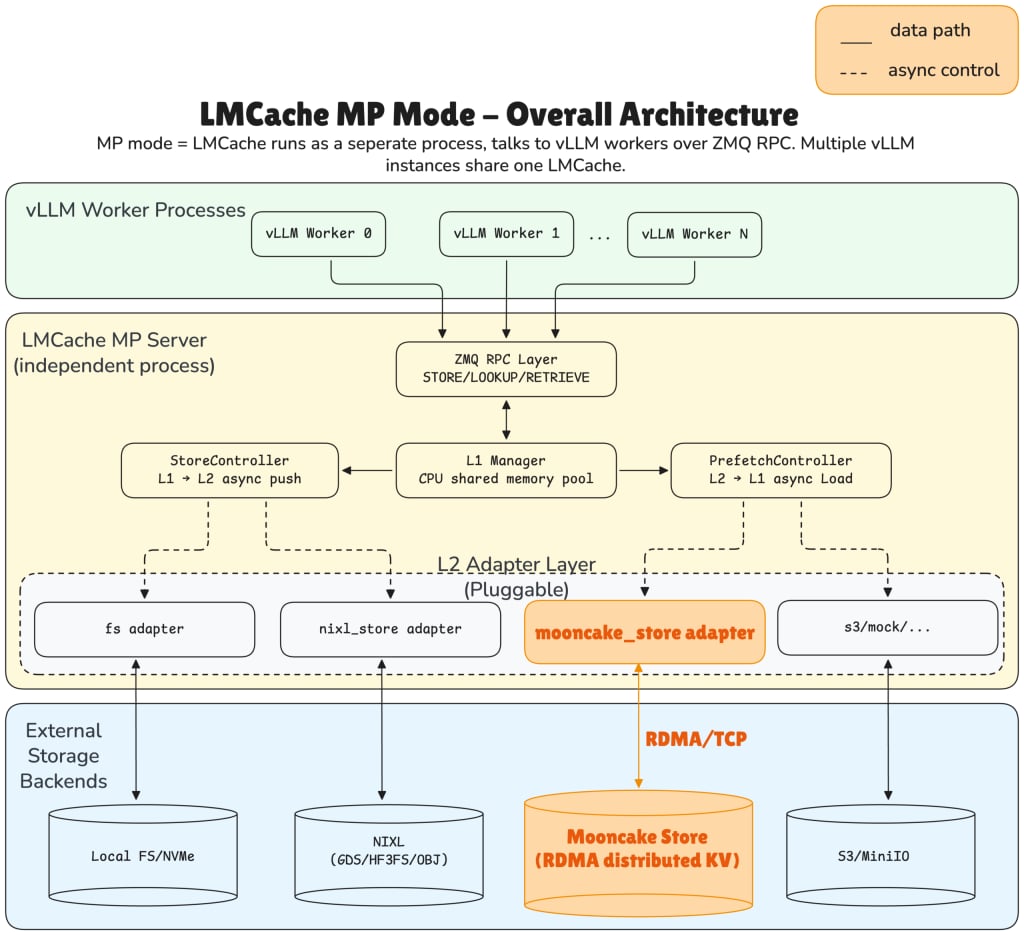
来源:When Open Source Meets Open Source: A Joint Effort Between LMCache and Mooncake(LMCache 官方博客,2026-05-26)。图中 L1 是 CPU 共享内存池,L2 是通过适配器接入的外部存储。
mooncake_store adapter 访问它。L2 → L1 的预取占用 CPU 内存;执行模型前,仍需将 KV 加载到引擎分配的 GPU KV 块中。
图中的 mooncake_store adapter 位于 LMCache 内部,负责接入 Mooncake Store;引擎侧的 LMCacheMPConnector 负责衔接 vLLM 的调度与加载、保存操作。两者串联后,Mooncake Store 就成为 LMCache 可使用的外部缓存后端。
vLLM Worker 与 LMCache 的 KV 搬运
Worker 与 LMCache Server 运行在不同进程中。保存 KV 时,需要将引擎中分散的分页块收集到缓存缓冲区,这一步称为 gather;恢复时,将缓存中的 KV 写回引擎分配的分页块,称为 scatter。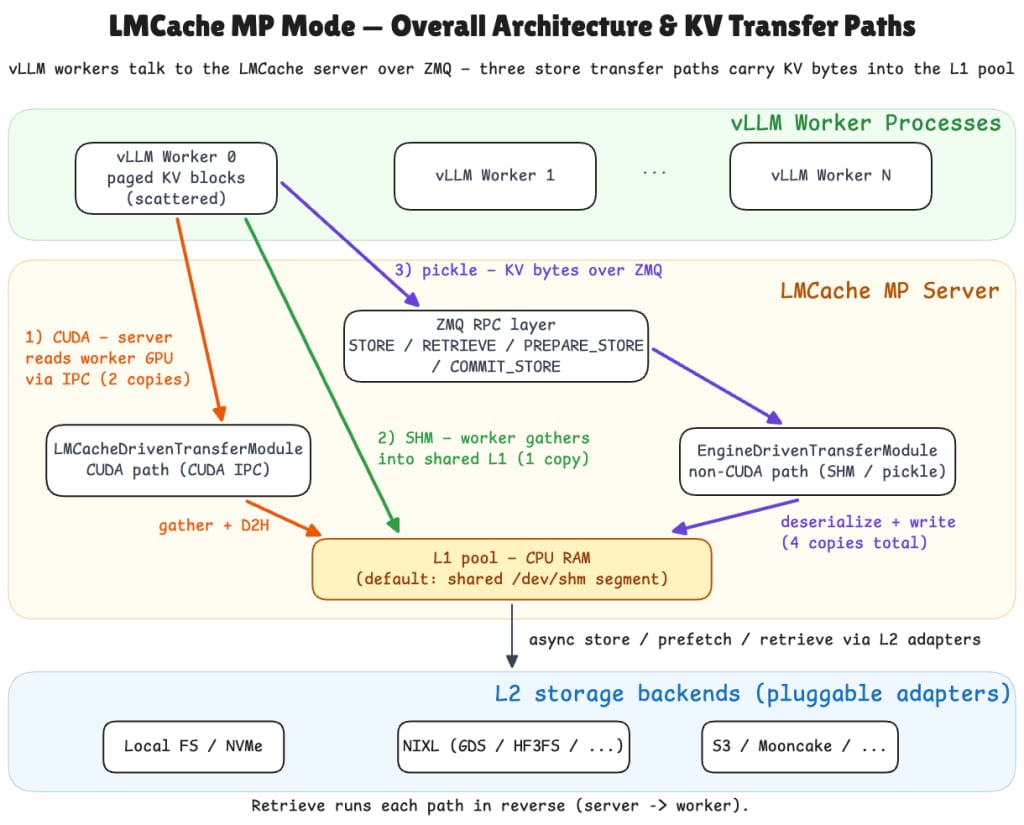
来源:Understanding LMCache MP Mode Transfer Paths: A Beginner’s Guide(LMCache 官方博客,2026-06-15)。三条彩色路径展示 Worker → CPU L1 的保存过程,恢复时反向搬运。
KV 的三种部署路径
KV 可以在引擎间直接交接,也可以通过外部缓存保存和复用:- P → D 直接传输:通过
NixlConnector或MooncakeConnector,把当前请求的 KV 从 P 交接给 D。 - vLLM → Mooncake Store:通过
MooncakeStoreConnector直接接入共享缓存池,保存和加载可复用的 KV。 - vLLM → LMCache → Mooncake Store:通过
LMCacheMPConnector接入 LMCache,再由mooncake_store adapter访问 Store。LMCache 管理 L1 内存池及 L1/L2 之间的保存与预取,Mooncake Store 提供共享存储。
MultiConnector 组合使用。
LMCache 与 MultiConnector
LMCache 的 MP 分离式 Prefill 示例 使用MultiConnector 组合两条路径:NixlConnector 负责本次请求的 P→D KV 交接,LMCacheMPConnector 负责引擎与独立 LMCache Server 之间的保存、查询和恢复。
根据上述 LMCache MP 示例整理;图中只画 KV 数据路径,省略请求路由与握手。两侧的 LMCache Server 分别保存各自引擎的 KV。
KV 的保存、复用与释放
引擎内缓存与外部缓存
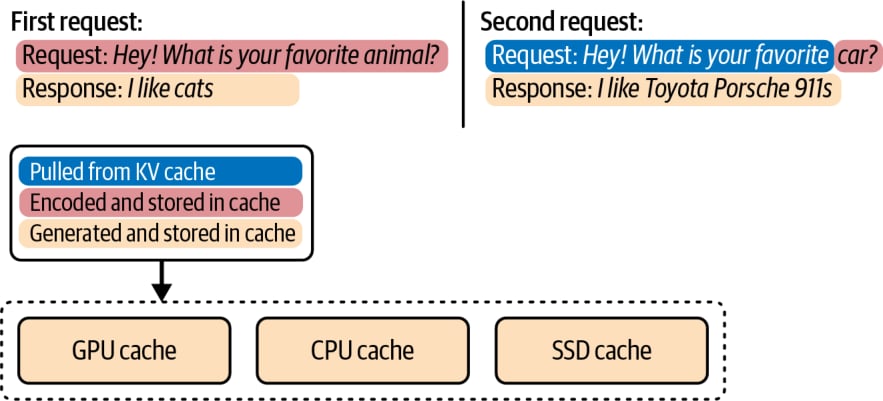
原书图 17-5。KV 可以保存在 GPU、CPU 或 SSD 中,具体使用哪些层级取决于部署。
P 少算多少与 D 少传多少
P、D 各有自己的本地 KV Cache。P 命中前缀可以减少 Prefill 计算;D 命中前缀可以减少需要接收的 KV。 假设请求包含 10,000 个 prompt token,P 已缓存前 8,000 个 token 的 KV,只需计算后 2,000 个。对于全注意力模型,D 在继续生成时仍需要完整的历史 KV,但其中有多少需要从 P 接收,取决于 D 自己已经缓存了多少:KV 块的保留与释放
在上述 NIXL Pull 实现中,如果 P 已为交接保留了 KV,而 D 的本地缓存恰好全部命中,D 仍需通知 P:本次交接已经结束,可以解除对这些块的保留。解除传输占用后,这些 KV 是否继续作为 Prefix Cache 保留,由 P 的本地缓存策略决定。 请求取消时,P 可能仍在发送 KV,D 已经分配了接收空间,外部存储也可能通过租约暂时保留着副本。这些内存不能一起立即释放。尤其是通信超时,只代表等待时间超限,不代表读写已经停止;回收内存前必须确认旧操作不会再访问它。 “缓存中没找到”和“传输到一半失败”也要分开处理。前者通常可以转为计算缺失部分;后者要按后端的错误处理策略执行。LMCache MP 示例将 NIXL 加载失败设为fail,而它的 L2 缓存适配器目前不区分加载失败与缓存未命中。能否在 D 上重新计算,还取决于 D 是否支持 Prefill,以及当前请求是否允许改走这条路径。
Worker 选择与请求转发
llm-d 先选 D,再决定是否使用远端 P
llm-d 在 Kubernetes 中组织 vLLM 实例,将请求路由、P/D 之间的 KV 交接、共享前缀缓存和副本扩缩容连接起来。原书图 15-4 展示了这些组件的关系。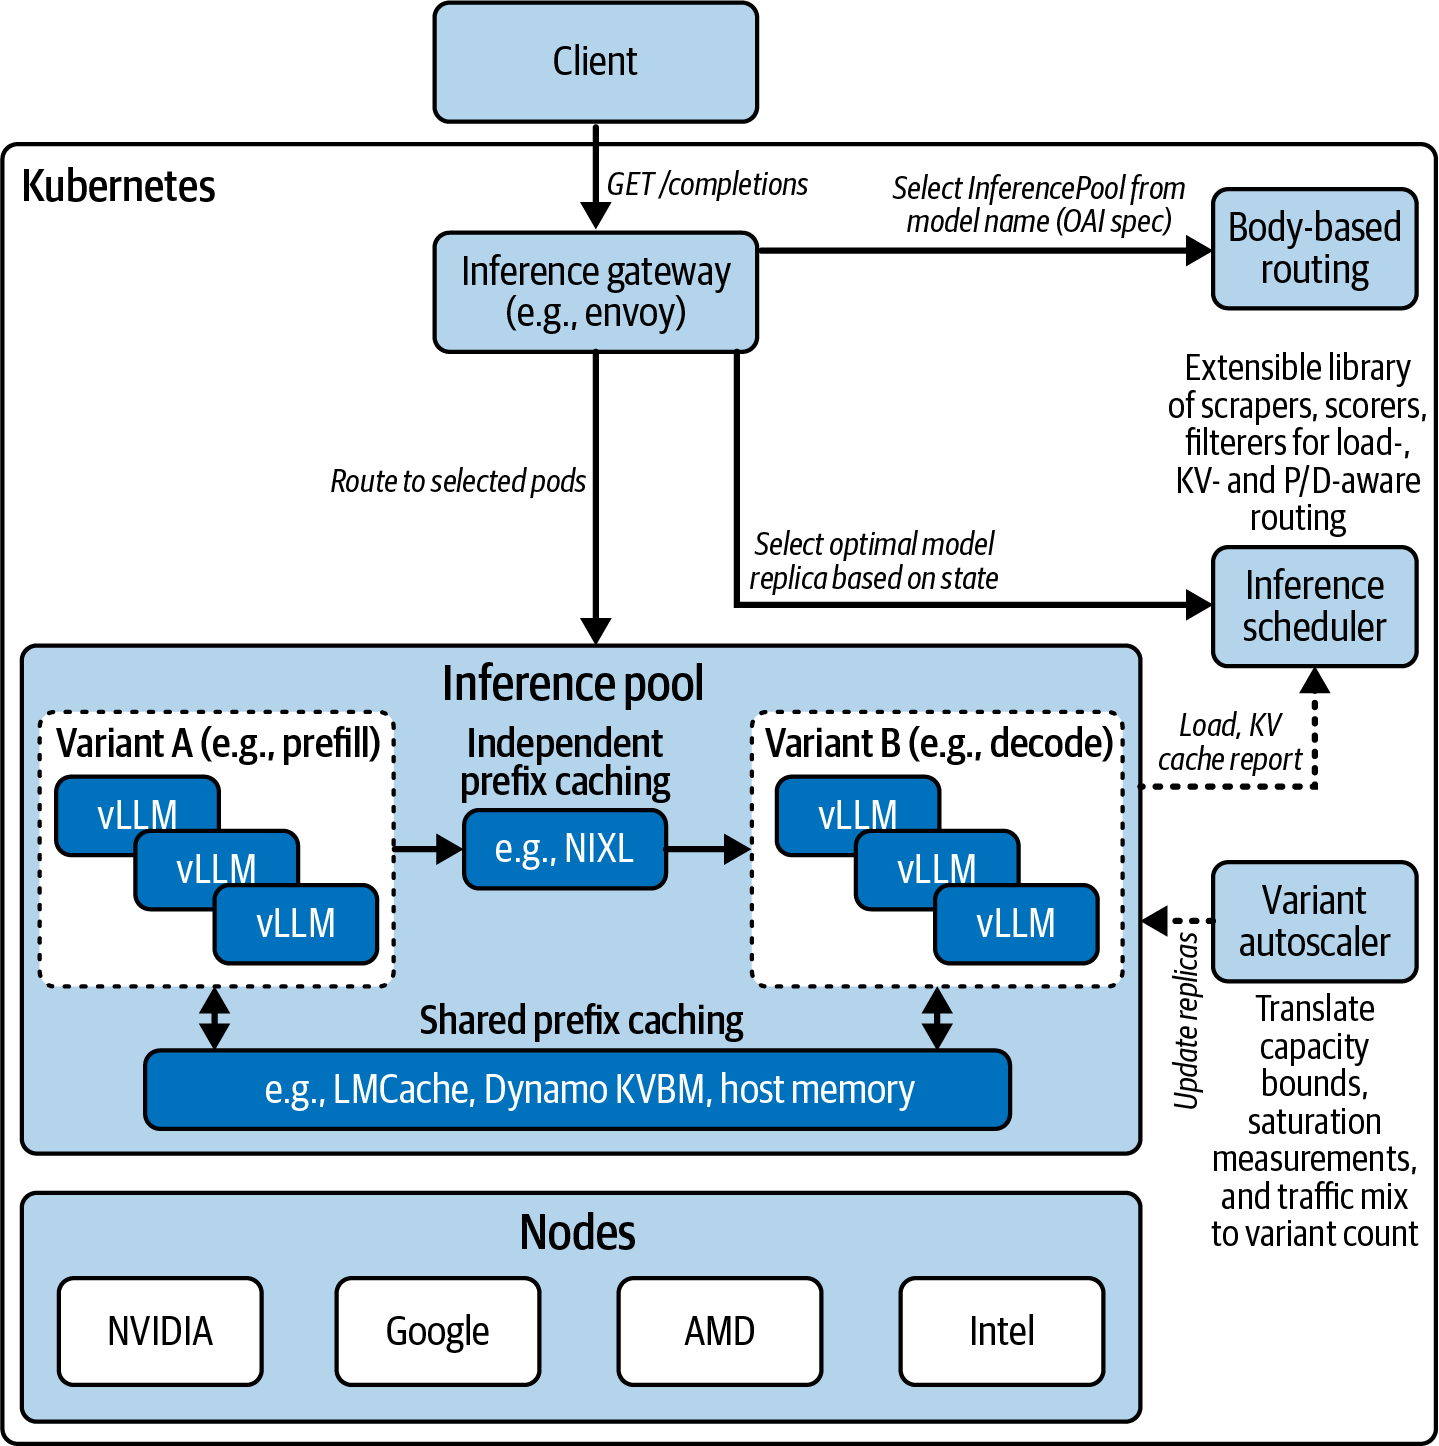
原书图 15-4:基于 Kubernetes 的 llm-d / vLLM 分离式推理架构。图片来自[中英对照 Markdown 仓库](https://github.com/notlate-cn/ai-systems-performance-engeering/blob/e3cd9597ffd7b8d7b236b4eca8b289e1affb7217/docs/assets/images/ch15/fig15_995_1.png),对应[原书第十五章的说明](https://github.com/notlate-cn/ai-systems-performance-engeering/blob/e3cd9597ffd7b8d7b236b4eca8b289e1affb7217/docs/chapters/ch15.md)。图中的缓存后端是架构示例。
llm-d 官方请求转发图
llm-d 官方请求转发图

disagg-profile-handler 按以下顺序选择实例:
- 选择 D:运行 Decode profile,确定目标 Decode 实例。
- 判断是否分离:decider 根据已选 D 上未缓存的 prompt 部分,决定是否选择远端 P。
- 按需选择 P:需要分离时运行 Prefill profile,将 P、D 地址一起交给代理。
KVTransferParams 后再调用 D,由 D 拉取 KV。SGLang 的交接路径则使用 bootstrap 信息协调 P、D,可并发发起两侧请求。Sidecar 的控制顺序要适配引擎协议,不能只把后端名称替换掉。
Dynamo + vLLM 的路由与交接
截至 2026-10-25,Dynamo v1.6.0 与主分支的基础 vLLM PD 示例 使用集成 Frontend 和NixlConnector。在未启用条件式分离时,PrefillRouter 先选择并请求 P,收到 Prefill 的交接信息后,再把请求送入 D 的路由阶段。
P 侧的 vLLM Handler 将生成长度设为 1,返回 disaggregated_params,其中的 kv_transfer_params 包含源端块和连接信息。Frontend 将这些信息放入 D 请求的 prefill_result;D 侧 Handler 再把传输参数交给 vLLM 引擎。
译自 [Dynamo 分离式路由文档](https://github.com/ai-dynamo/dynamo/blob/701da25292ecca8f64d770cc0b17d389200019a1/docs/fern/pages/developer-guide/knowledge-base/modular-components/router/disaggregated-serving.md)的请求流程图,对应未启用条件式分离的 vLLM 路径。实线表示请求与响应,虚线表示缓存事件;实际 KV 在 P、D 之间传输。
WAITING_FOR_REMOTE_KVS。Worker 侧的 NIXL Pull 实现 发起 READ,从 P 读取 KV;加载完成后,Scheduler 才让请求恢复执行。Dynamo 决定请求交给哪个实例,vLLM Scheduler 管理实例内的计算与块分配,Connector 执行两者约定的 KV 交接。
未启用条件式分离时,D 路由的配置 将 overlap_score_credit 设为 0,也就是不因 D 的前缀匹配程度给它加分。D 引擎仍可检查自己的本地前缀缓存;路由评分与引擎实际复用是两个步骤。如果 P、D 分布在不同机架或区域,还可以根据已选 P 的位置限制 D 的候选范围。
在这条 Frontend 路径中,P 请求或交接信息处理失败会返回错误,不会因此自动切换为 D 本地 Prefill。D 引擎内部的 KV 加载失败则由 vLLM 的 kv_load_failure_policy 等配置决定,可以选择重算或失败返回;实际可用的恢复方式还取决于 Connector 和引擎配置。
原书对照:2025 年 Decode-centric 交接
原书对照:2025 年 Decode-centric 交接
DynamoNixlConnector。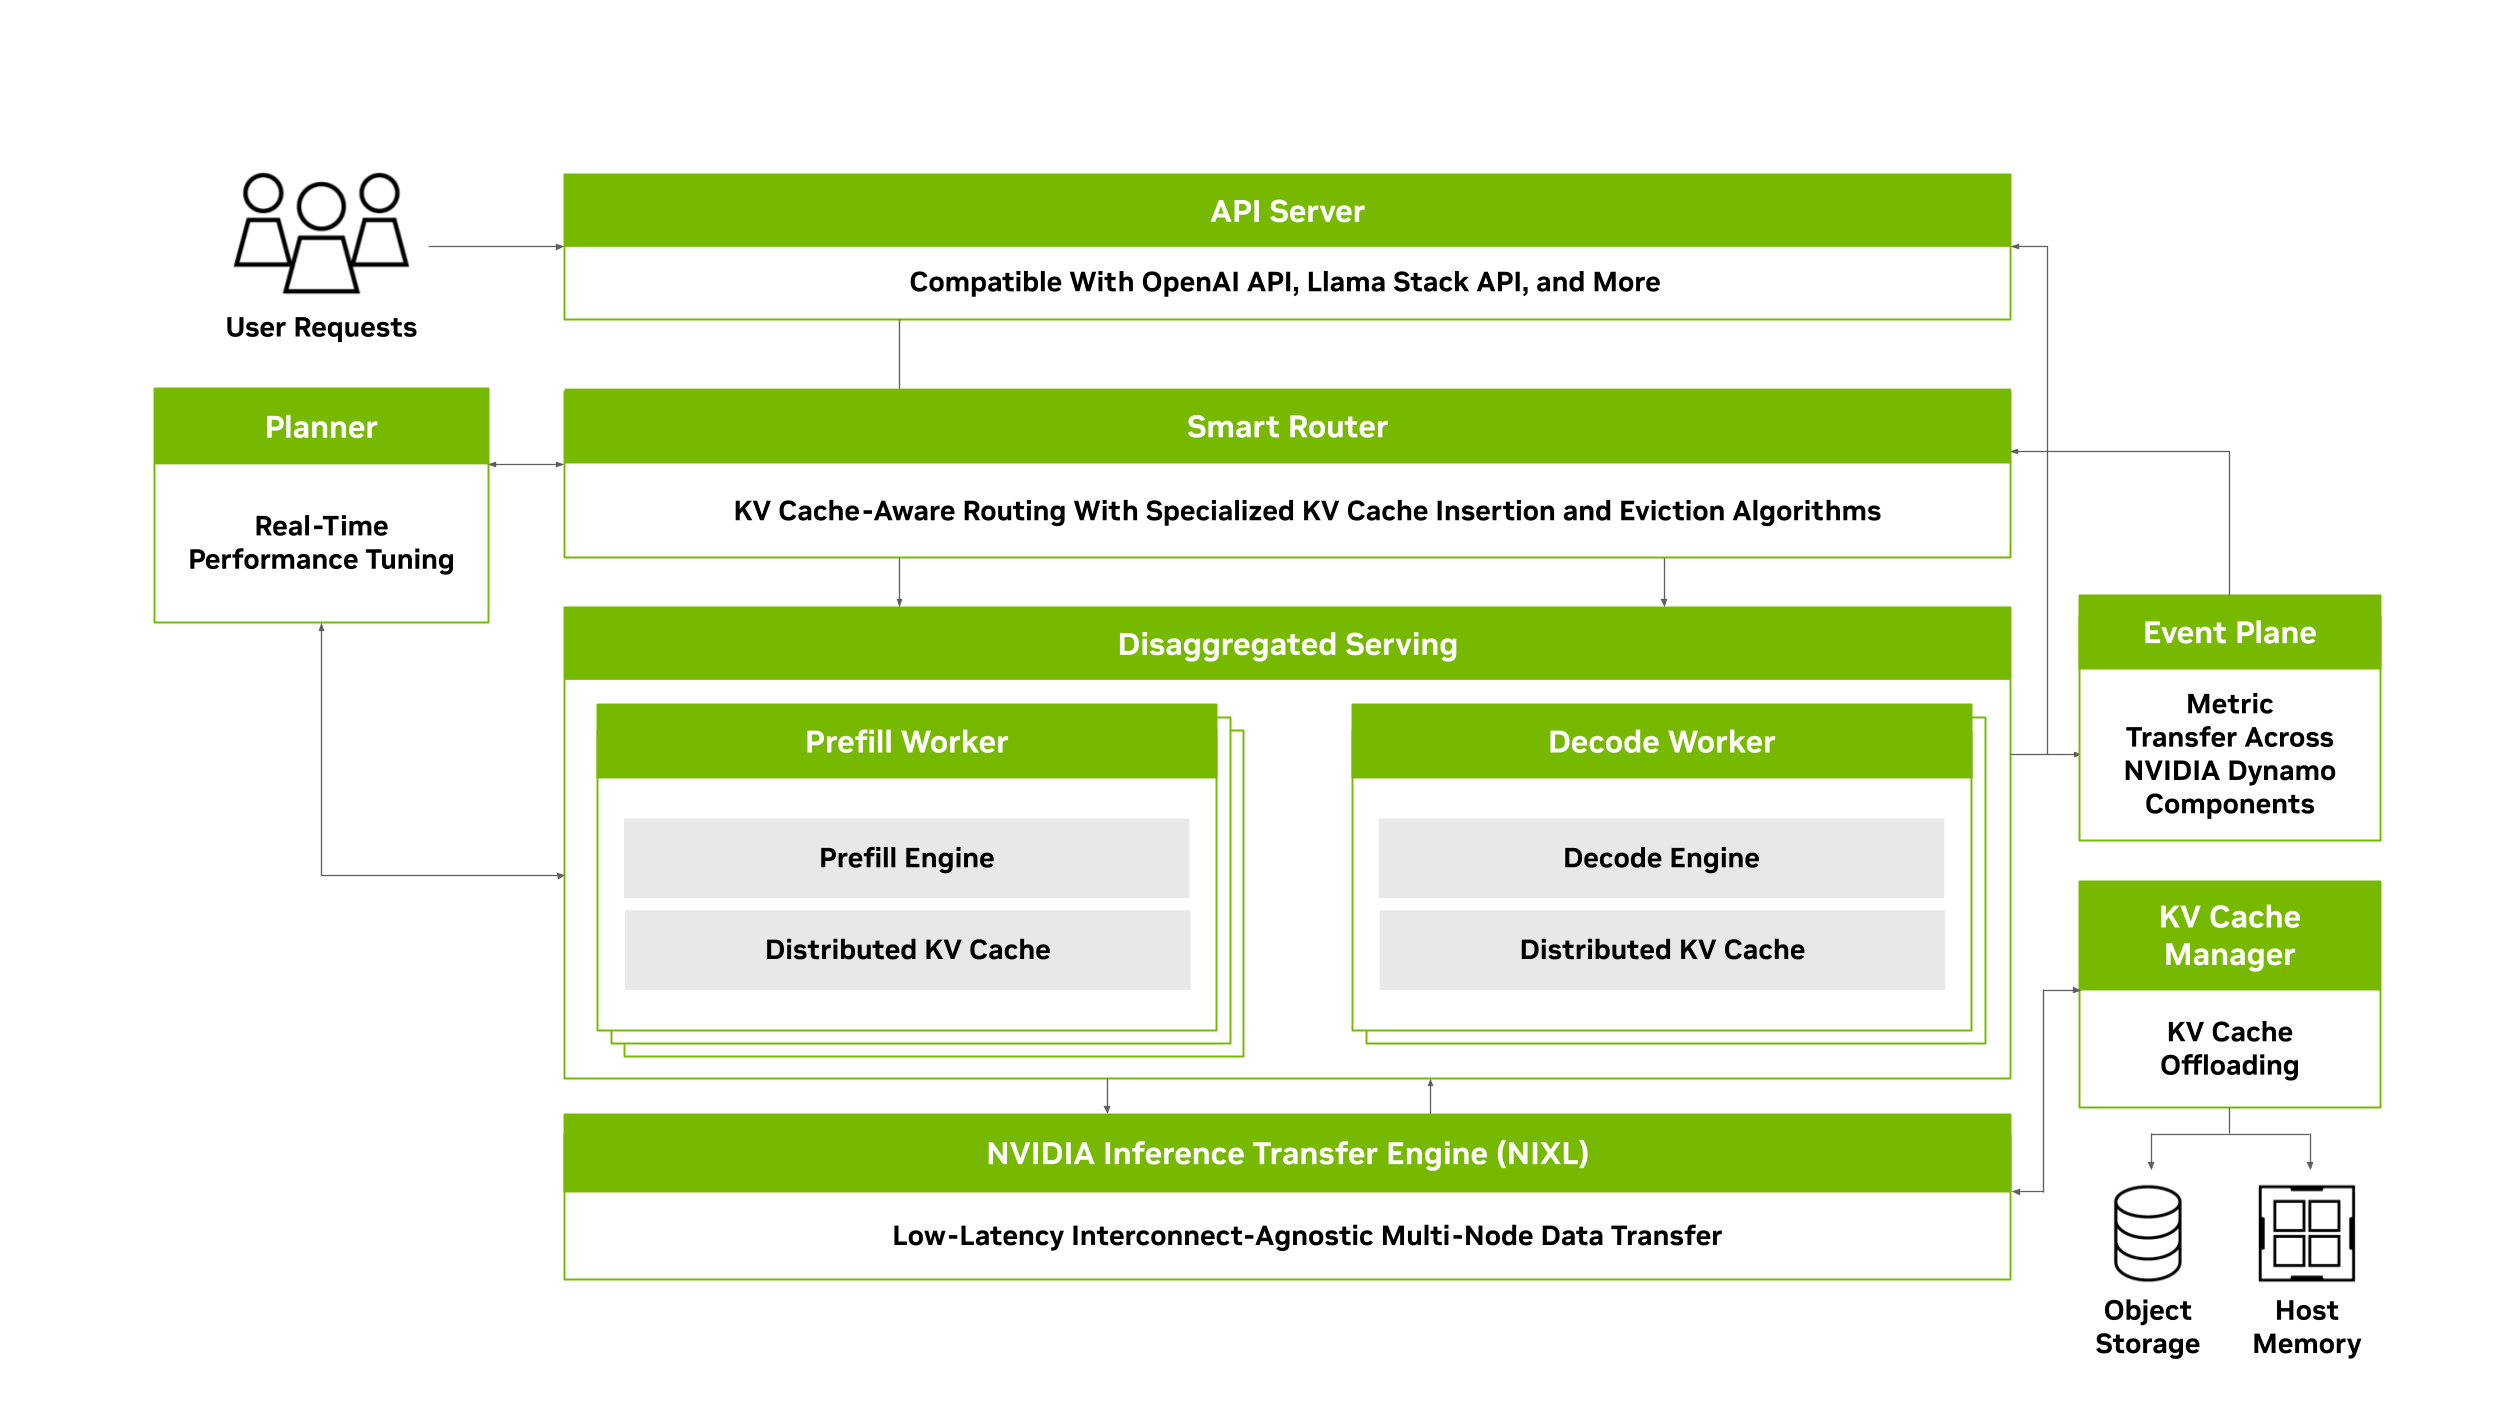
来源:NVIDIA Dynamo 官方介绍,2025 年 3 月,图 3。此图展示组件关系,Decode-centric 的请求顺序见后面的时序图。
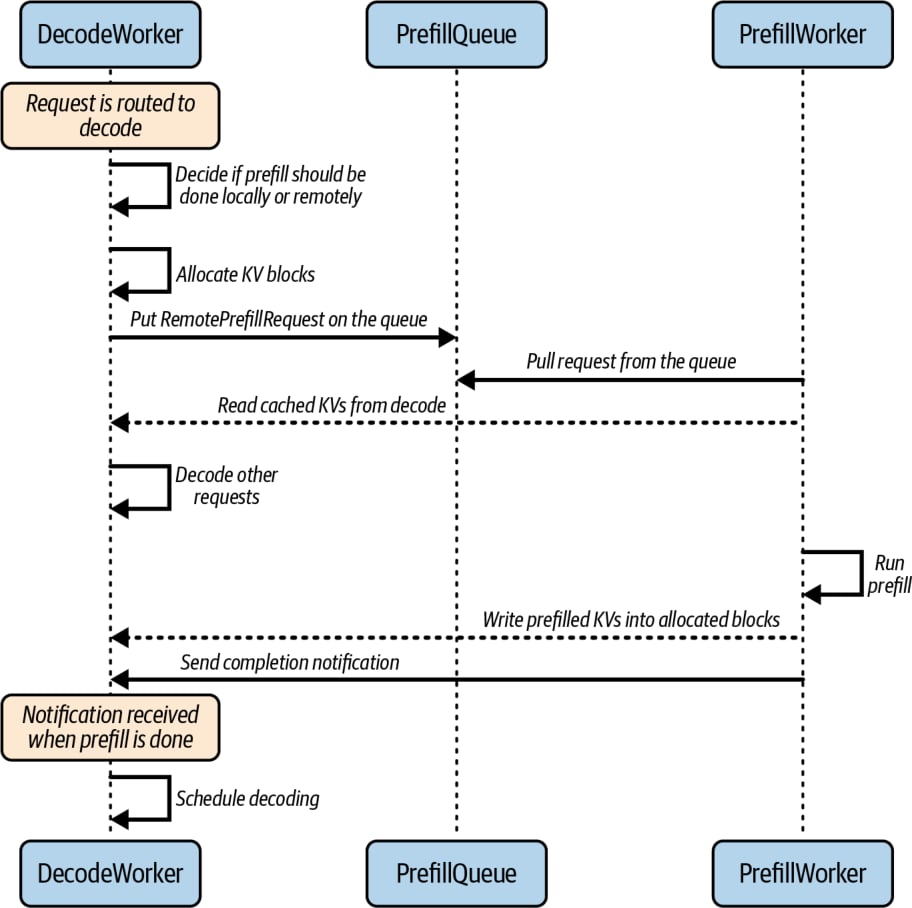
原书图 17-3,来源:中英对照 Markdown 仓库。图中的队列传递 Prefill 任务和块信息,KV 数据在 P、D 之间直接传输。
- D 接收请求并分配空间:检查本地前缀缓存,结合待计算的 Prefill 长度和排队情况决定是否使用远端 P;需要远端计算时,准备接收 KV 的块。
- P 领取 Prefill 任务:任务携带请求和 D 的目标块信息。原书图中还包含一条可选路径:P 读取 D 已缓存的前缀,减少重复计算。
- P 计算并传回 KV:P 完成缺失部分的 Prefill,通过 NIXL 将 KV 写入 D 已分配的块,然后发送完成通知。
- D 开始生成:接收完成后,把该请求加入 Decode 调度;等待 KV 期间,D 可以继续处理其他请求。
DynamoNixlConnector、当前用于 PD 的 NixlConnector 和接入 KVBM 的 DynamoConnector 属于不同实现。Dynamo 的条件式分离
Conditional Disaggregation 在 v1.6.0 中属于默认关闭的实验功能。开启--router-conditional-disagg 后,Router 可以在派发到 P 之前,选择让某个 D 本地执行 Prefill 和 Decode。该功能要求 KV-aware 路由及 D 的缓存事件;vLLM 的 P、D 都需配置事件发布。
Router 用 prompt 长度减去候选 D 的缓存前缀,估计仍需计算的 token 数,再按配置的策略比较其数量、占 prompt 的比例或 P 的负载。还可以配置 D 的负载上限,避免将额外 Prefill 压到繁忙的 D 上。选择本地执行时,Router 添加 x-bypass-remote-prefill 标记,D 侧 Handler 据此按聚合模式处理该请求;计算仍由本地 vLLM Scheduler 安排。
开启该策略后,D 的路由按配置使用缓存匹配评分,不再被普通分离路径强制设为 0。这是一项在远端 Prefill 开始前做出的路由选择,与 P 执行失败后的重试不同;2025 年教程则由先收到请求的 D 服务决定是否调用远端 P。
两种路由路径的对比
结合缓存与负载选择 Worker
Dynamo 根据 vLLM 事件记录缓存位置
Dynamo Router 根据引擎发布的 KV stored/removed(保存/移除)事件,记录哪些前缀存在哪些 Worker 或缓存层。实际 KV 由 vLLM 等组件保存,Router 保存的是位置记录。选择 Worker 时,Router 同时考虑能复用多少前缀,以及该 Worker 当前有多忙。 在 Dynamo Router + vLLM 本地 Prefix Cache 的组合中,两侧分别执行缓存管理和路由策略:BlockRemoved 事件;Dynamo 收到后更新对应的位置记录。即使事件尚未到达,实际执行时仍由 vLLM 检查缓存是否可用。提高 Router 对缓存命中的权重,会改变实例选择;本地块的保留与淘汰仍按引擎策略执行。
如果再接入 Dynamo KVBM、LMCache 或 Mooncake Store,外部副本还受对应缓存组件的保留与淘汰策略控制。例如,GPU 中的副本已经淘汰,CPU 或存储中的副本仍可能存在;引擎需要通过 Connector 加载后才能使用。
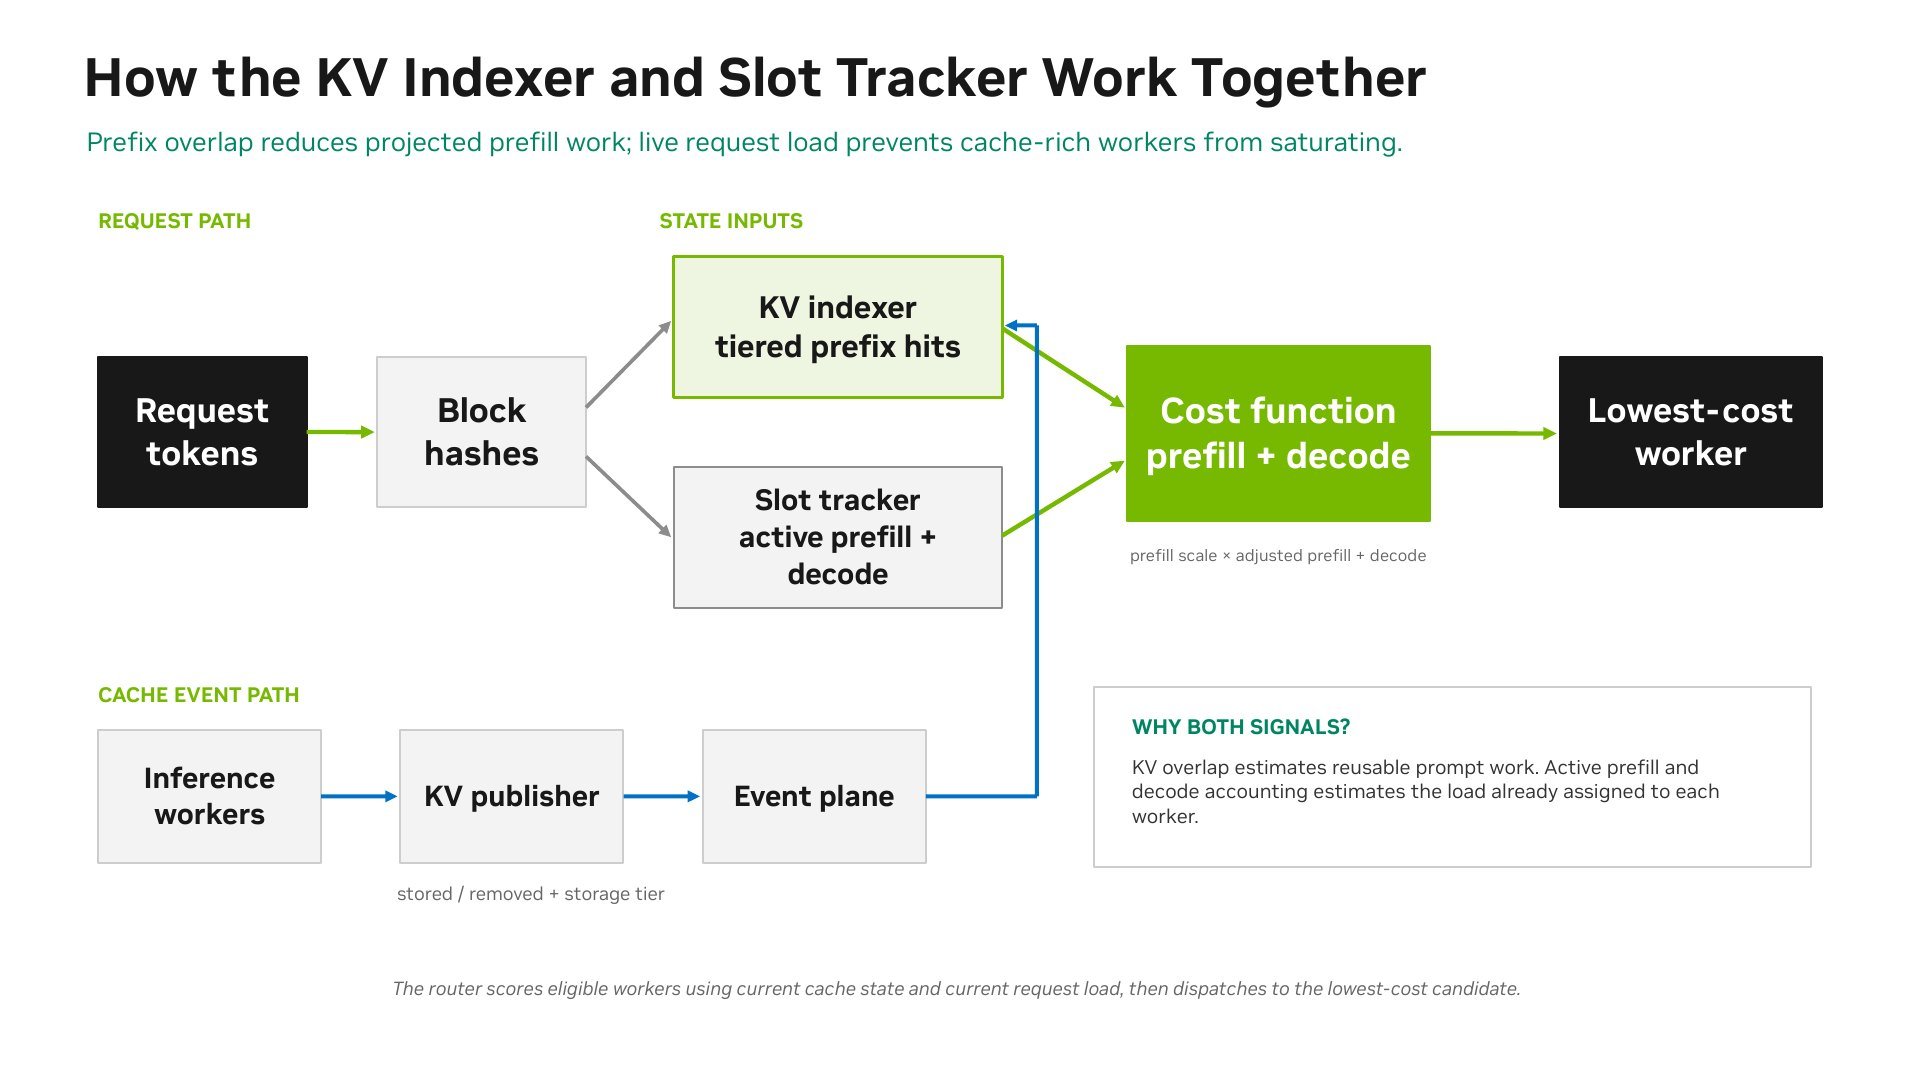
来源:Dynamo — Routing Concepts。KV Indexer 提供前缀匹配信息,Slot Tracker 跟踪正在处理的请求负载。
SGLang Router 根据请求历史估计缓存位置
Radix Tree(基数树)把相同前缀放在同一条路径上,不同后缀在分叉处展开。引擎可以用它查找已有 KV,Router 也可以用它记录请求曾发给哪个 Worker。两者使用相似的数据结构,但后者只能推测 KV 是否还在。 SGLang Gateway 的CacheAwarePolicy 记录请求文本及其被分配到的 Worker。后续请求出现相同前缀时,就据此估计哪个 Worker 可能有缓存。这省去了每次向 Worker 查询完整缓存的开销,但旧 KV 可能已经被淘汰。
该实现先判断负载是否明显失衡:绝对负载差和相对比例同时越过阈值时,优先选择低负载实例;负载较平衡时,使用前缀匹配和阈值选择实例,匹配不足时转向最小负载。具体行为以链接中的策略实现为准,不把它推广到 SGLang 的所有路由模式。
根据上述 CacheAwarePolicy 源码整理的正常选择流程,假定候选 Worker 健康且近似树已建立。树中记录的是请求前缀与 Worker 的对应关系。
Prefill 与 Decode 的扩缩容和过载处理
Dynamo Planner 预测需求并根据负载调整实例数
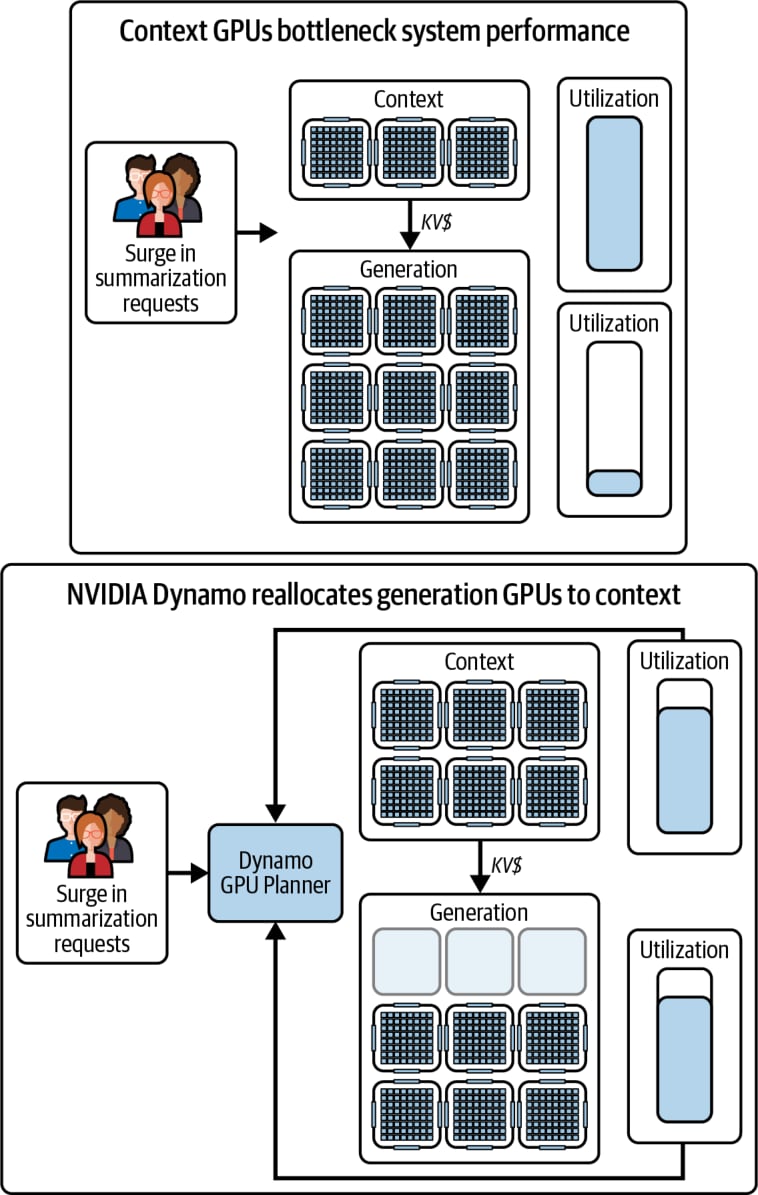
原书图 17-7,用于说明双池容量随输入、输出需求变化;当前控制流程见 Dynamo Planner Design。
- Throughput-based 预测:使用流量、输入输出长度及性能模型估计容量需求,调整周期较慢。
- Load-based 修正:根据实际前向计算耗时、排队情况和 Worker 状态,更快地调整实例数。
Mooncake 提前拒绝预计无法按时完成的请求
Mooncake 论文 从资源受限下的过载出发:如果请求完成 Prefill 后没有满足延迟目标的 Decode 容量,已经投入的 Prefill 计算和 KV 传输可能无法产生有效结果。其 early rejection 策略尝试在投入这部分资源前,预测请求进入 Decode 时的负载并决定是否接纳。 如果只看 D 现在是否繁忙,容易出现反复波动:D 忙时大量拒绝新请求,等现有请求完成后,又可能没有足够的新请求进入 D;此时集中接收请求,经过一段 Prefill 时间,D 又会变忙。论文因此估计请求完成 Prefill 后的负载,再决定是否接收。Planner 调整实例数量,early rejection 则在容量暂时不变时决定接收哪些请求。 当前开源 Mooncake Conductor 提供全局前缀索引和查询服务;不能把论文中完整的调度与拒绝策略视为安装 Transfer Engine 或 Store 后自动获得的行为。多模态 EPD 分离
EPD 在多模态推理中进一步拆出 Encode(编码)阶段,让视觉编码与语言模型的 Prefill、Decode 分开调度。独立的编码池可以按图像负载调整批量和容量,减少视觉编码对语言模型计算的干扰;在文本与图像混合流量中,纯文本请求也能减少等待图像编码造成的阻塞。编码占比较高时,这有助于改善 TTFT 和满足延迟约束的 goodput。 代价是增加 embedding 传输、跨 Worker 协调和排队。独立编码 Worker 如果与语言模型共享 GPU,仍会竞争算力;如果独占 GPU,则可能因图像请求不足而闲置。E、P、D 的容量也需要匹配:P 或 D 已经繁忙时,继续增加 E 可能扩大下游队列。NVIDIA 的 EPD 分析比较了这些部署方式和负载条件。编码 Worker 的放置方式
下图从左到右分别是聚合执行、Worker 分开但共享 GPU,以及编码池使用独立 GPU。中间方案分开队列与批处理;右侧方案进一步隔离硬件资源,并通过 NIXL 传递 embedding。图中的 P、D 仍共置,拆出 E 可以独立于 PD 分离实施。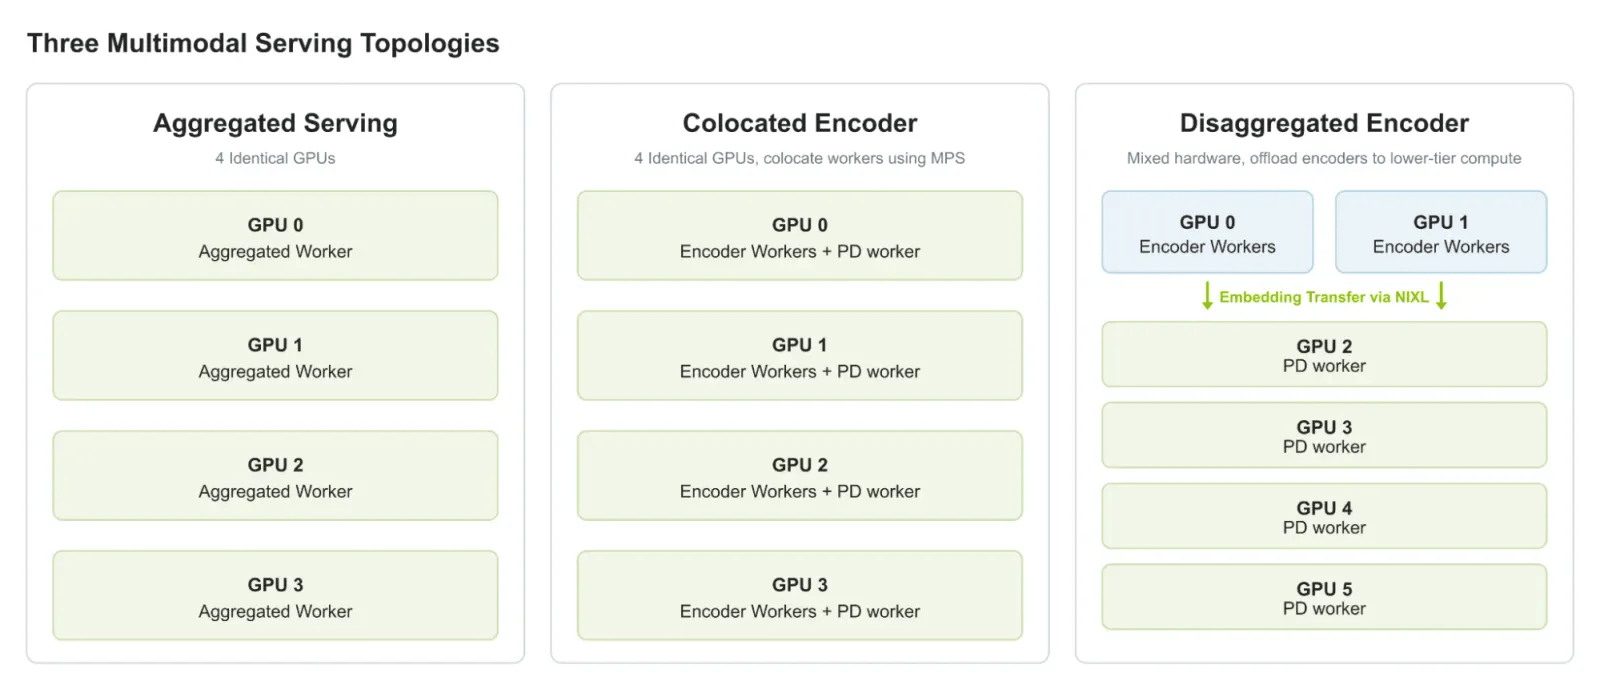
来源:NVIDIA — When to Use Encode-Prefill-Decode Disaggregation,图 3。右侧方案额外使用编码 GPU,需要计入总资源与成本。
编码池与 Embedding 交接
Dynamo 的 Encoder Disaggregation 将视觉编码从语言模型执行路径移到独立 Encode Worker。E 计算图像 embedding,再交给下游语言模型;P 完成 prompt 计算并把 KV 交给 D。E 传的是图像特征,P 传的是语言模型的 KV,分别供后续不同的计算使用。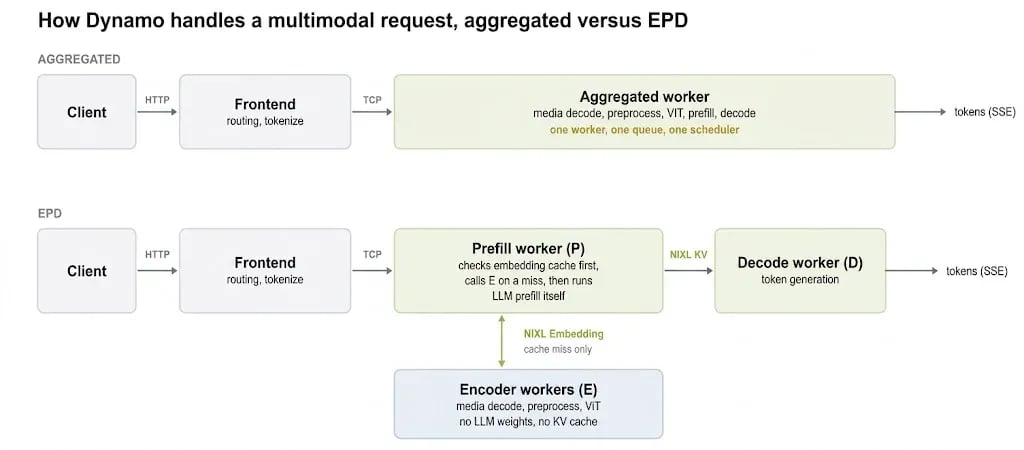
来源:NVIDIA Dynamo — EPD Disaggregation for Multimodal Inference。图中的 embedding 缓存与请求关系对应该文描述的路径。
Embedding 与 KV 的复用范围
Embedding Cache 与 KV Prefix Cache 也需要分开统计。前者复用视觉编码结果,后者复用语言模型针对当前 prompt 已经算出的 KV;相同图片放进不同 prompt,并不自动构成完整的语言模型前缀命中。图中先查 embedding cache、未命中再访问 E 的做法,可以避免重复编码,但 P 仍需完成尚未复用的语言模型计算。 支持范围随后端与版本变化。例如上述 v1.2.1 文档中,vLLM 独立 E 处理image_url,video_url 留在 P/PD 路径;不能把“三池部署”直接推导为所有多模态输入都已支持独立编码。
图像负载与输出长度
图像编码越重,拆分 E 越可能缓解瓶颈;输出越长,Decode 在端到端延迟中的占比越大,单独优化编码的收益就越有限。下图统计相对聚合部署的端到端延迟降幅:列是“图片数 × 每张图片的视觉 token 数”,行是输出长度 OSL。左图在5×128、输出 2048 token 时为 −2.5%,即该配置下延迟反而增加。
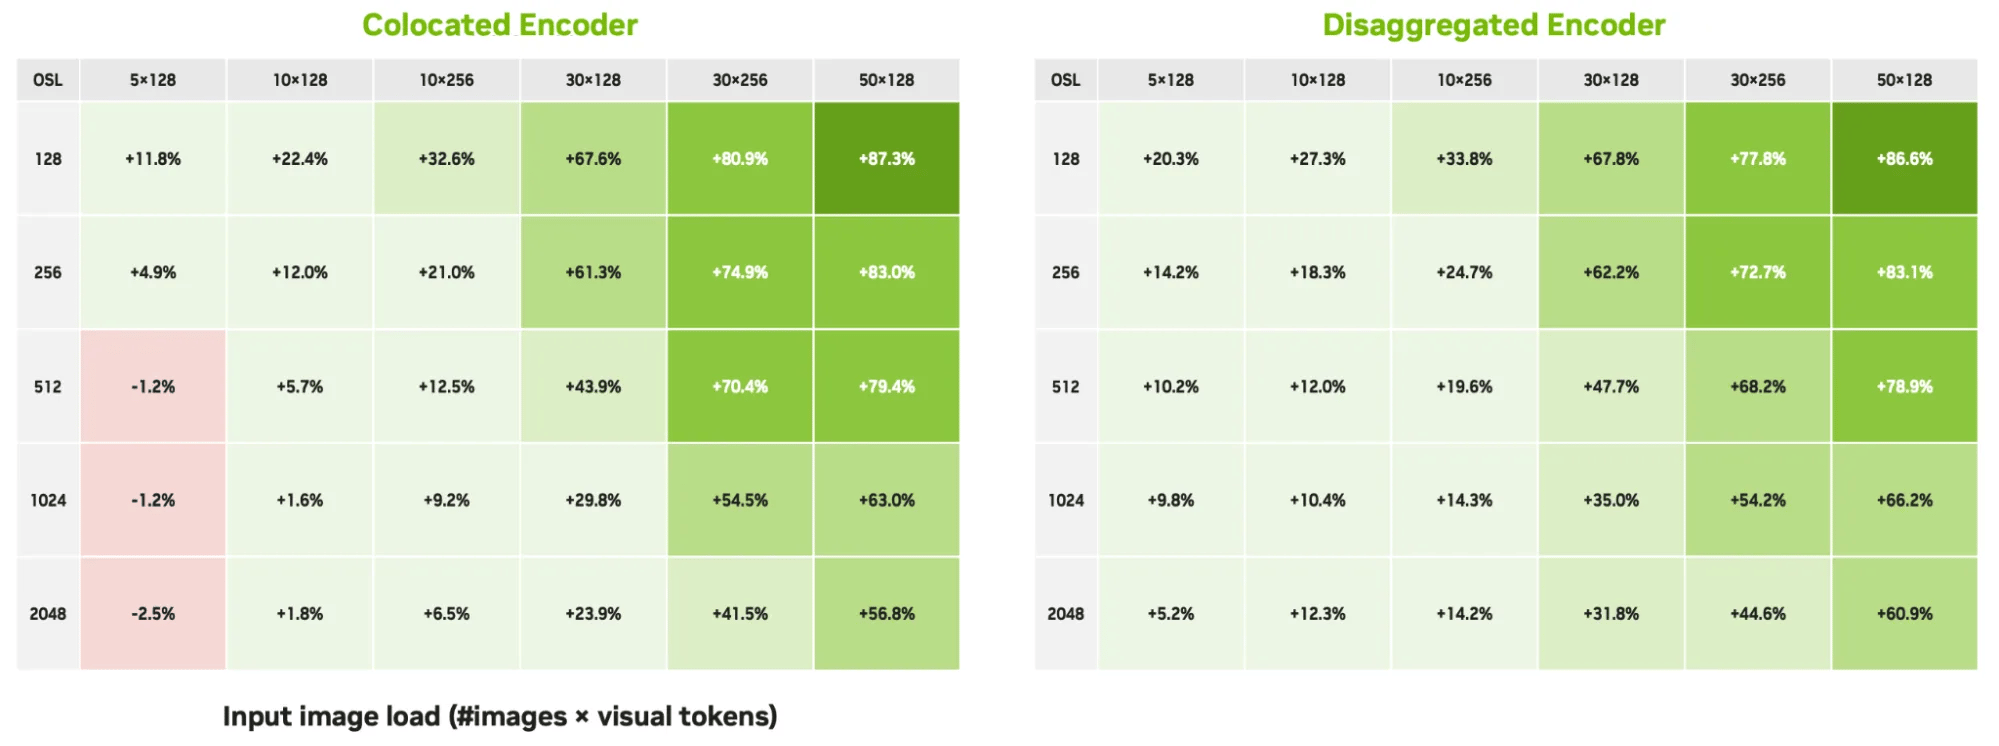
来源:NVIDIA EPD 实验,图 8。模型为 Qwen3.5 122B A10B NVFP4;基线和左图均使用 4 张 GB200,右图在 4 张 GB200 之外增加 2 张 RTX 6000D。数值是端到端延迟降幅,正值表示改善。
Attention–FFN 分离
AFD 把同一层中的 Attention 和 FFN(前馈网络)交给不同 Worker。Attention 一侧保存历史 KV,将算出的 hidden states(中间激活)发给 FFN;FFN 算完后返回结果,供后续计算继续使用。PD 拆分请求的前后两个阶段,AFD 拆分每一层中的两部分计算,两者可以组合。 收益是两侧可以分别选择设备数量、批量和并行方式:Attention 根据序列长度和 KV 显存需求配置资源,FFN/MoE 根据 token 数量和专家负载配置资源,减少两类计算共用一套部署配比的限制。vLLM AFD Plugin将这一分工实现为独立的 Attention 服务和 FFN 服务。 代价是每个拆分层都增加激活传输与同步。Decode 每生成一个 token 都要重复这些交接,任一侧排队都会拖慢后续计算,因此 TPOT 对通信延迟和两侧负载失衡更敏感。通信与计算重叠可以隐藏部分等待;批量太小、网络较慢或资源配比不合适时,传输成本可能超过独立部署的收益。vLLM AFD Plugin 分开执行 Attention 与 FFN

来源:vLLM AFD Plugin 官方介绍。图展示插件总体架构,兼容性以对应源码版本为准。
send_attn_output、recv_ffn_output 等接口,传递中间激活,以及当前层、执行阶段和 token 排列等信息。AFDFFNWorker 不分配 KV Cache,而是根据 Connector 传来的任务信息执行 FFN 计算。
两种 Connector 参与的工作不同:
- KVConnector:告诉调度器哪些 KV 可从外部获取,再利用调度器分配的块完成加载。
- AFD Connector:在模型执行每一层时,在 Attention 与 FFN 的执行进程之间传递中间激活。
每个 Token 都要重复的通信
Attention 输出完成后,需要经历发送、FFN 排队与计算、结果返回,才能继续依赖该结果的计算。微批流水线或 Dual Batch Overlap 可以将一个微批的等待与另一个微批的计算重叠,但可隐藏的时间受可并行工作、依赖关系和批量限制。 FastAFD 解读提供了插件与重叠执行的图解。分析 TPOT 时,需要区分已被计算覆盖的通信时间,以及仍处在当前 token 执行路径上的传输和等待。Attention 与 FFN 的资源配比
vLLM 官方实验中,48A16F 表示 48 个 Attention 执行进程(rank)与 16 个 FFN 执行进程;硬件数量按芯片裸片(die)统计。EP64 是未做 Attention–FFN 分离的专家并行基线。
16K 输入下,与使用 64 个 die 的 EP64 相比,同样使用 64 个 die 的 48A16F 单位 die 吞吐下降 5.3%;使用 80 个 die 的 64A16F 则提高 11.3%。拆分后的配比影响收益,按 die 归一化也不能替代相同总资源的比较。
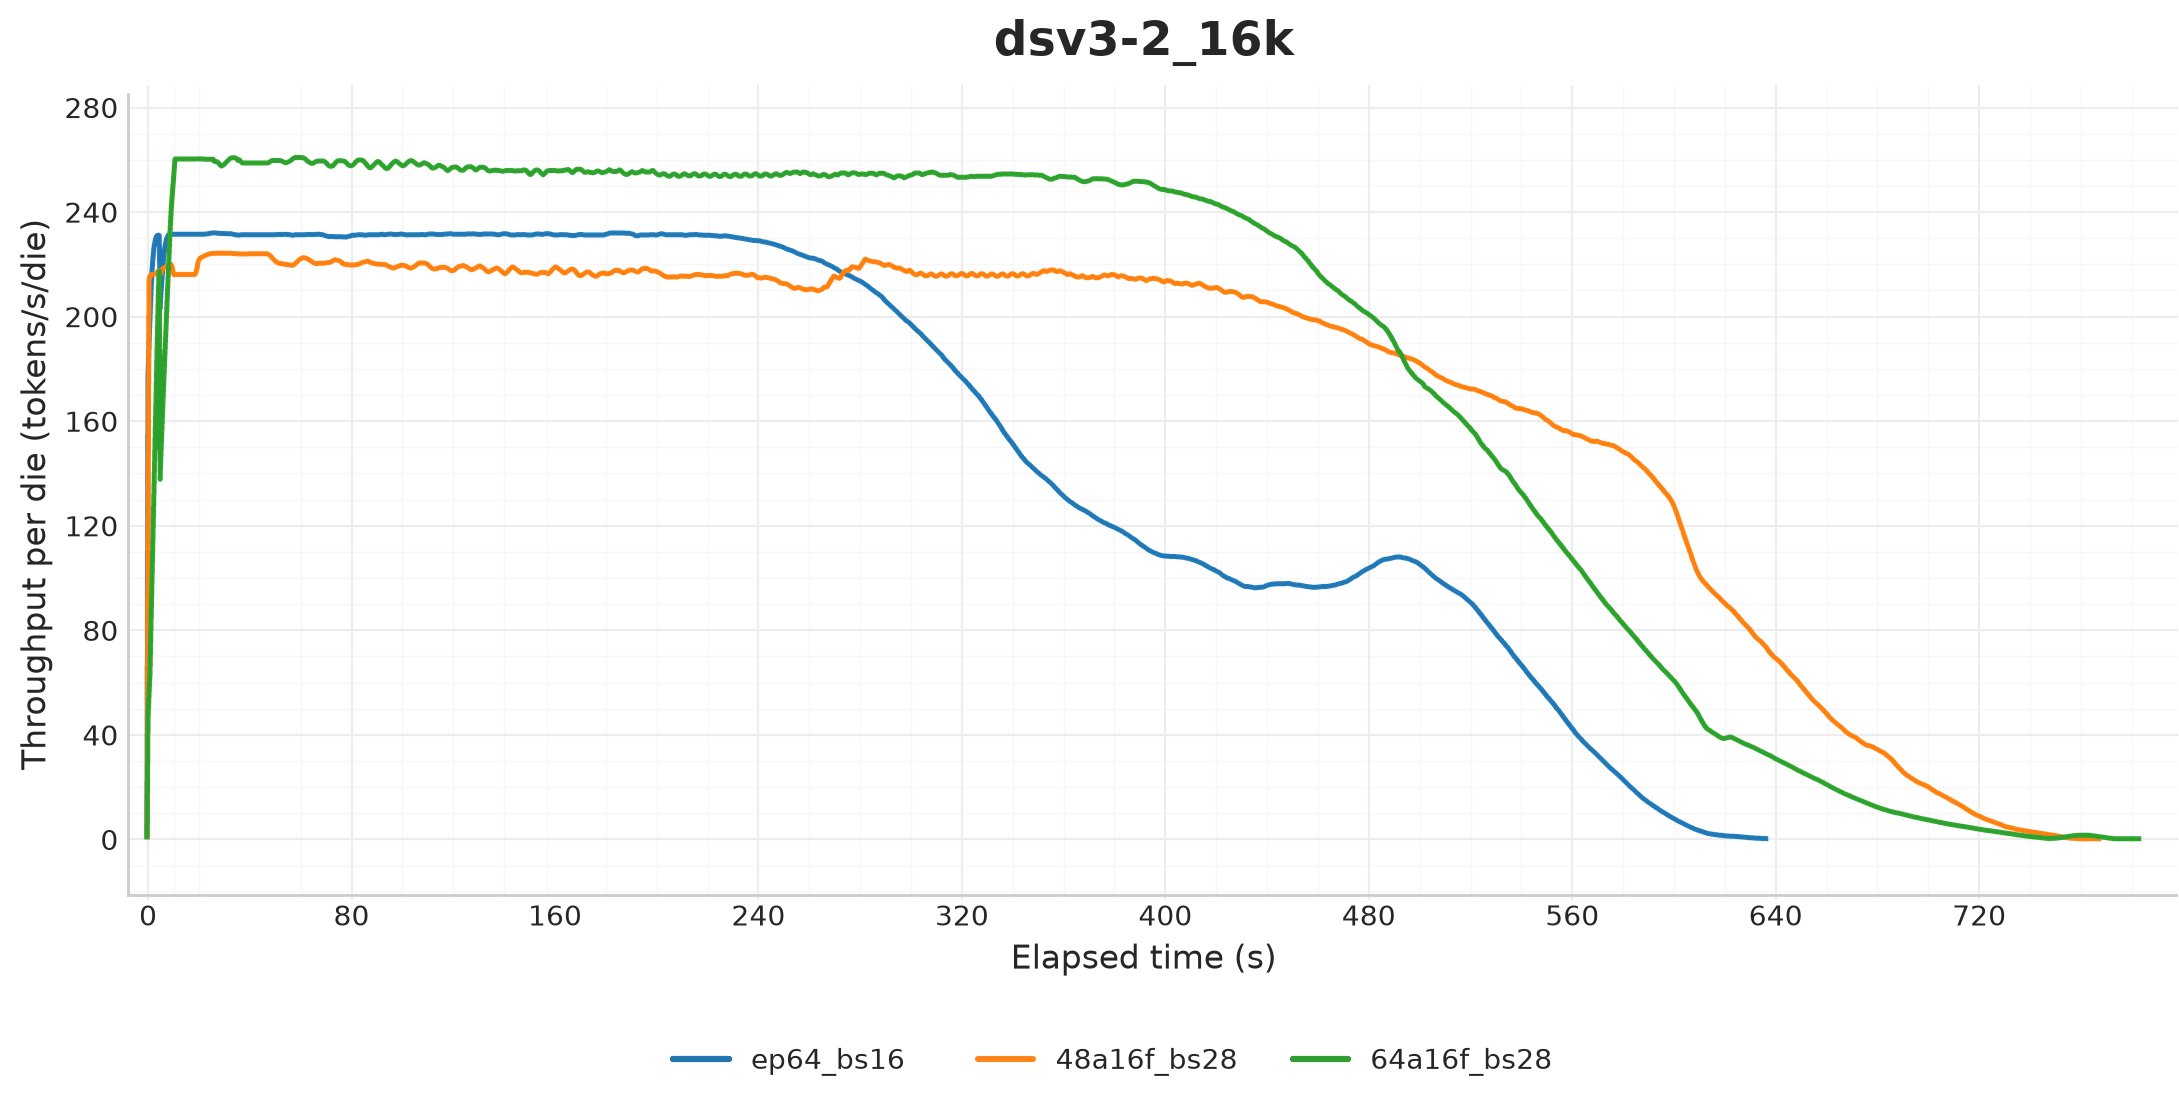
来源:vLLM AFD Plugin — 16K fixed input。DeepSeek-V3.2 W8A8,Ascend 910C;输入固定为 16K,输出为 512–1536 token 均匀分布。横轴是运行时间,纵轴是单位 die 的输出 token 吞吐。
NVIDIA GPU 与 LPU 的异构 Decode
NVIDIA 描述的异构 Decode 路径让 GPU 持有 KV 并执行 Attention,LPU 执行 FFN/MoE,两侧交换中间激活。图中的循环发生在逐 token 的模型执行过程中,适合说明 AFD 的硬件映射:历史 KV 留在 Attention 侧,另一类设备承担 FFN 计算。 这是厂商公布的系统架构描述,与 vLLM AFD Plugin 是两个不同层次的实例。前者说明异构硬件分工,后者提供可查看源码的 Worker 和 Connector 接口;不能据此声称该插件已经实现或验证了 GPU/LPU 路径。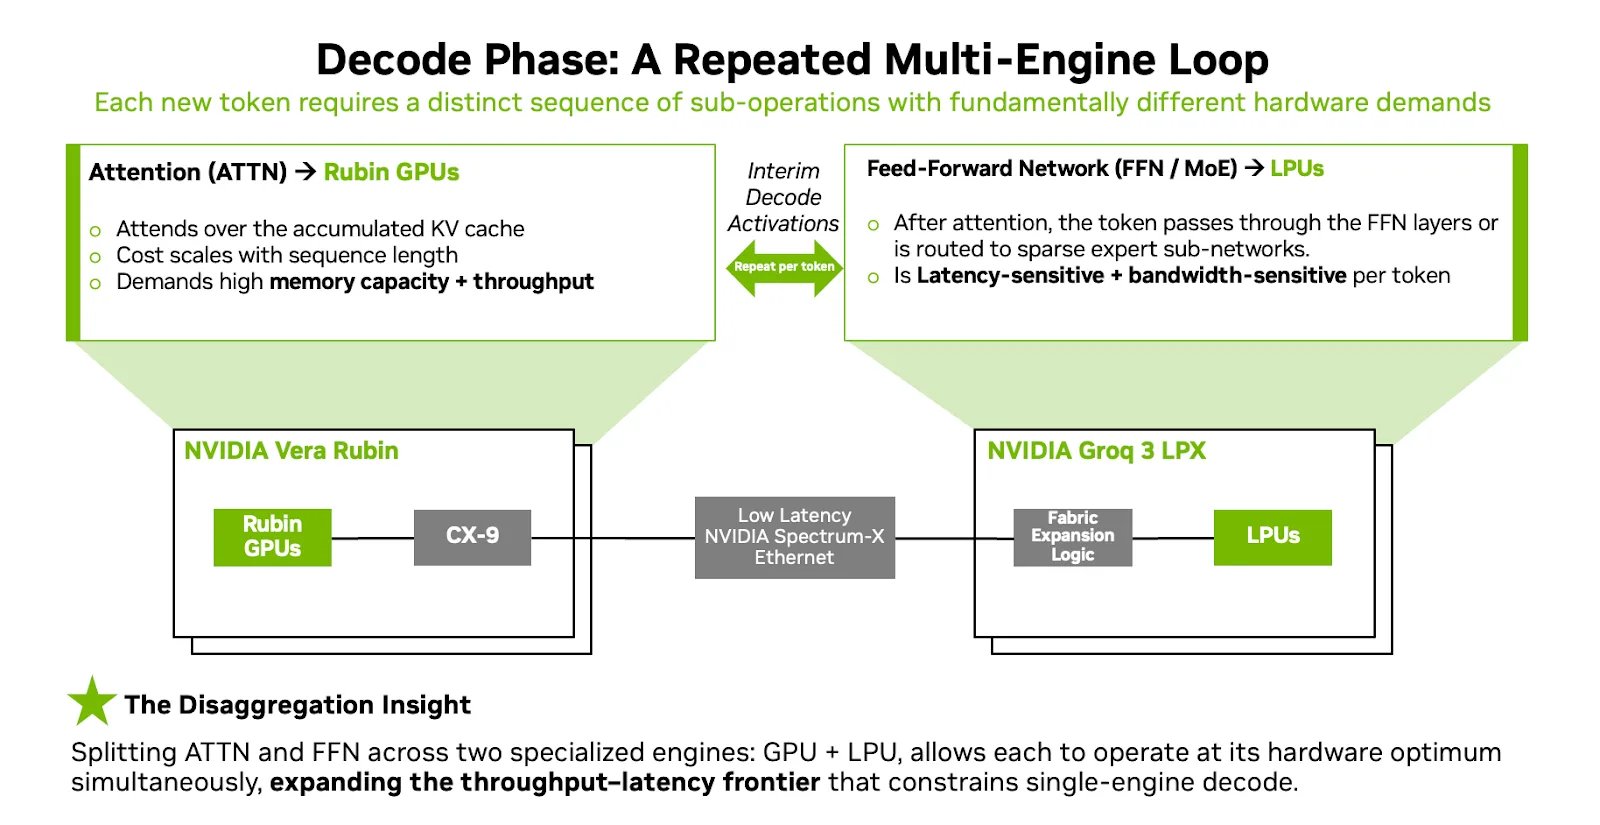
性能测试与排查指标
比较分离前后的性能,需要使用相同的模型、总资源、请求分布和 SLO。除了 TTFT、TPOT,还要分开记录每一步花了多久、占用了多少 KV 空间,才能找出慢在哪里:参考资料
源码说明基于以下固定快照,部署兼容性与默认参数应以所用发行版为准。 Dynamo + vLLM 的请求交接与条件式分离于 2026-10-25 复核:Dynamo 最新稳定版为 v1.6.0,并对照当日主分支。v1.6.0 发布说明配套的 vLLM 为 v0.31.0;下表另列 vLLM 主分支,用于核对 Scheduler 与 NIXL 接口,不能将两者视为同一套部署版本。项目源码与核对版本
项目源码与核对版本
- AI Systems Performance Engineering 中英对照版本:原书第十七章正文与配图索引。
- NVIDIA Dynamo Tutorial — GTC 2025(S73042):视频及配套课件。课件第 32 页展示早期 Decode-centric 时序,第 38–39 页给出 P、D 的
DynamoNixlConnector配置。 - 解构 vLLM KV Connector:从调度解耦到全局零拷贝池化(vLLM 小课堂中文图解):Scheduler/Worker 分工、逐层传输与请求级异步、L2 预取,以及 LMCache、Mooncake 的接入,附原视频和课件链接。
- Push-based KV Transfer with NIXL:Pull/Push 交接时序与实现。
- When Open Source Meets Open Source: A Joint Effort Between LMCache and Mooncake(LMCache 官方博客,2026-05-26):MP 模式架构、L1/L2 之间的异步保存与预取,以及 Mooncake Store 适配器的接入。
- Understanding LMCache MP Mode Transfer Paths: A Beginner’s Guide(LMCache 官方博客,2026-06-15):Worker 与 LMCache L1 之间的 CUDA IPC、SHM 和 pickle 搬运路径,gather/scatter,以及复制次数的适用条件。
- Mooncake: Kimi’s KVCache-centric Architecture for LLM Serving:缓存调度与过载下的提前拒绝。
EPD 分离
- When to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving(NVIDIA 官方博客,2026-09-09):编码拆分的收益与代价、共享 GPU 与独立 GPU 的选择,以及图像负载和输出长度对收益的影响。正文的三种部署方式图取自图 3,端到端延迟热力图取自图 8;实验硬件与统计口径见原文 Test environment。
- Dynamo Encoder Disaggregation(官方文档,v1.2.1):E/PD 与 E/P/D 部署方式、embedding 交接、各推理后端的支持范围和启动示例。
Attention–FFN 分离
- Announcing vLLM AFD Plugin: Disaggregating Attention and FFN for Flexible MoE Serving(vLLM 官方博客,2026-07-23):Attention/FFN 的资源需求、Worker 与 Connector 架构,以及不同资源配比的性能实验。正文架构图与 16K Decode 吞吐图均来自此文;实验条件包括模拟逻辑规模和强制专家均衡。
- vLLM AFD Plugin README(源码快照
bcc0126):插件安装、版本要求、支持的后端与执行方式;Connector 接口约定说明激活与执行信息的交接方式。 - Inside NVIDIA Groq 3 LPX: The Low-Latency Inference Accelerator for the NVIDIA Vera Rubin Platform(NVIDIA 官方博客,2026-03-16):GPU 执行 Attention、LPU 执行 FFN/MoE 的异构 Decode 循环,也是正文 GPU/LPU 数据流图的来源。
- 大模型推理的内存与计算解耦:AFD 架构解析与性能验证(vLLM 小课堂中文技术解读):AFD 的资源配比、角色分工、双微批流水线与 FastAFD 优化图解,附原视频和课件链接。